
泊松回归
泊松回归针对固定时间、面积或产品数量内的事件计数,建立其与连续型和分类预测变量之间的模型。应使用它而不是普通回归,因为计数不能为负,且其离散程度随均值增大。假定响应服从泊松分布,采用对数、平方根或恒等连接函数。输出包括系数、偏差分析、拟合优度检验和残差图。
最后审阅
核心要点
泊松回归是一种广义线性模型,用最大似然法拟合,将每班缺陷数或每月故障次数等计数型响应与连续型和分类预测变量联系起来。
用途
泊松回归将每班缺陷数、每月故障次数或每块面板瑕疵数等计数型响应与连续型和分类预测变量联系起来。当响应是固定时间、面积或产品数量内的事件计数时,应使用它而不是普通回归:计数不能为负,且其离散程度随均值增大,而最小二乘法并未考虑这一点。
主要功能
- 连续型和分类预测变量,并可从项列表中选择交互作用项和平方项。
- 对数(默认)、平方根或恒等连接函数。
- 对项进行逐步、向前选择或向后剔除,并可将某些项强制纳入每个模型。
- 含置信区间和 VIF 的系数、分类预测变量每个水平的回归方程、模型汇总和拟合优度检验。
- 通过 Wald 检验或似然比检验(调整或序贯)进行偏差分析。
- 异常观测值、残差图、主效应图和交互作用图,以及拟合计数的等高线图和曲面图。
- 对您输入的设置进行预测,并提供响应优化器。
统计方法
假定响应服从均值为 μ 的泊松分布,μ 通过连接函数依赖于预测变量:采用对数连接函数时,ln μ = b₀ + b₁x₁ + …,因此预测变量每增加一个单位,每个系数会使期望计数乘以 exp(b)。该模型是用最大似然法(迭代重加权最小二乘)拟合的广义线性模型。分类预测变量相对于参考水平采用 (1, 0) 编码,默认以排序后的第一个水平为参考水平。含缺失值的行会被剔除;频数列用于重复行,权重列用于给出方差权重。
系数表给出 Wald z 值(Coef / SE Coef)和置信区间。偏差分析对每一项进行检验:默认使用 Wald 卡方(连续项为 z²,分类项为对其哑变量列的联合检验);使用 LR 检验时,则依据将该项从完整模型中去掉(调整,Type III)或按顺序加入(序贯,Type I)时偏差的变化。Deviance R-Sq = 1 − 残差偏差 / 零偏差。
拟合优度检验将偏差和 Pearson 卡方与误差自由度对应的卡方分布进行比较。p 值较小,或 Mean(偏差 / DF)远大于 1,表示计数的变异超出了泊松模型所允许的范围(过度离散),此时各项的 p 值会偏小。标准化残差超出 ±2 的观测值标记为 R,杠杆值大于 3p/n 的观测值标记为 X。
输入字段和选项
字段 | 说明 |
Response | 计数列。必填。 |
Continuous Predictors / Categorical Predictor | 数值型和文本(或编码)预测变量列;至少一列。按住 Ctrl 或 Command 并点击可多选。 |
Model terms (optional) | 项列表:勾选各项,或使用 Add all、Interactions 和 Powers,最高至 Terms through order 中选择的阶数(2 或 3)。取消勾选 In model 可去掉线性项而保留其交互作用项。 |
Reference level (optional) | 对于分类预测变量,格式为“Predictor Level”,以逗号分隔。默认:排序后的第一个水平。 |
Stepwise method | None(默认)、Stepwise、Forward selection 或 Backward elimination;另有 Alpha to enter 和 Alpha to remove(0.15)、层次规则、Terms in every model (E)、Initial model terms (I) 以及 Model selection details。 |
Frequency (optional) / Weights (optional) | 行频数列和权重列。 |
Link function | Log(默认)、Square root 或 Identity。 |
Confidence level / Type of confidence interval | 默认为 95,Two-sided;或 Lower bound 或 Upper bound。 |
Fits and diagnostics for all observations | 列出每一行的拟合值和残差,而不仅是异常观测值。 |
Test for ANOVA table / Type of deviance (LR test only) | Wald test(默认)或 LR test;对于 LR,可选 Adjusted (Type III,默认) 或 Sequential (Type I)。 |
Residuals for diagnostics/plots | Deviance(默认)或 Pearson。 |
Histogram of residuals / Normal probability plot of residuals / Residuals versus fits / Residuals versus order / Four in one / Residuals versus the variables | 残差图。 |
Main effects plot / Interaction plot | 拟合计数相对于每个预测变量的变化,其余预测变量保持在其均值或参考水平。 |
Contour plot / Surface plot / Overlaid contour plot of fitted values | 需要 X1 和 X2 坐标轴变量;叠加等高线图还需要 Response low 和 Response high。 |
Prediction / Response Optimizer | 添加一个面板,可在您输入的设置下预测平均计数(含 SE 和置信区间),或搜索满足计数目标的设置。 |
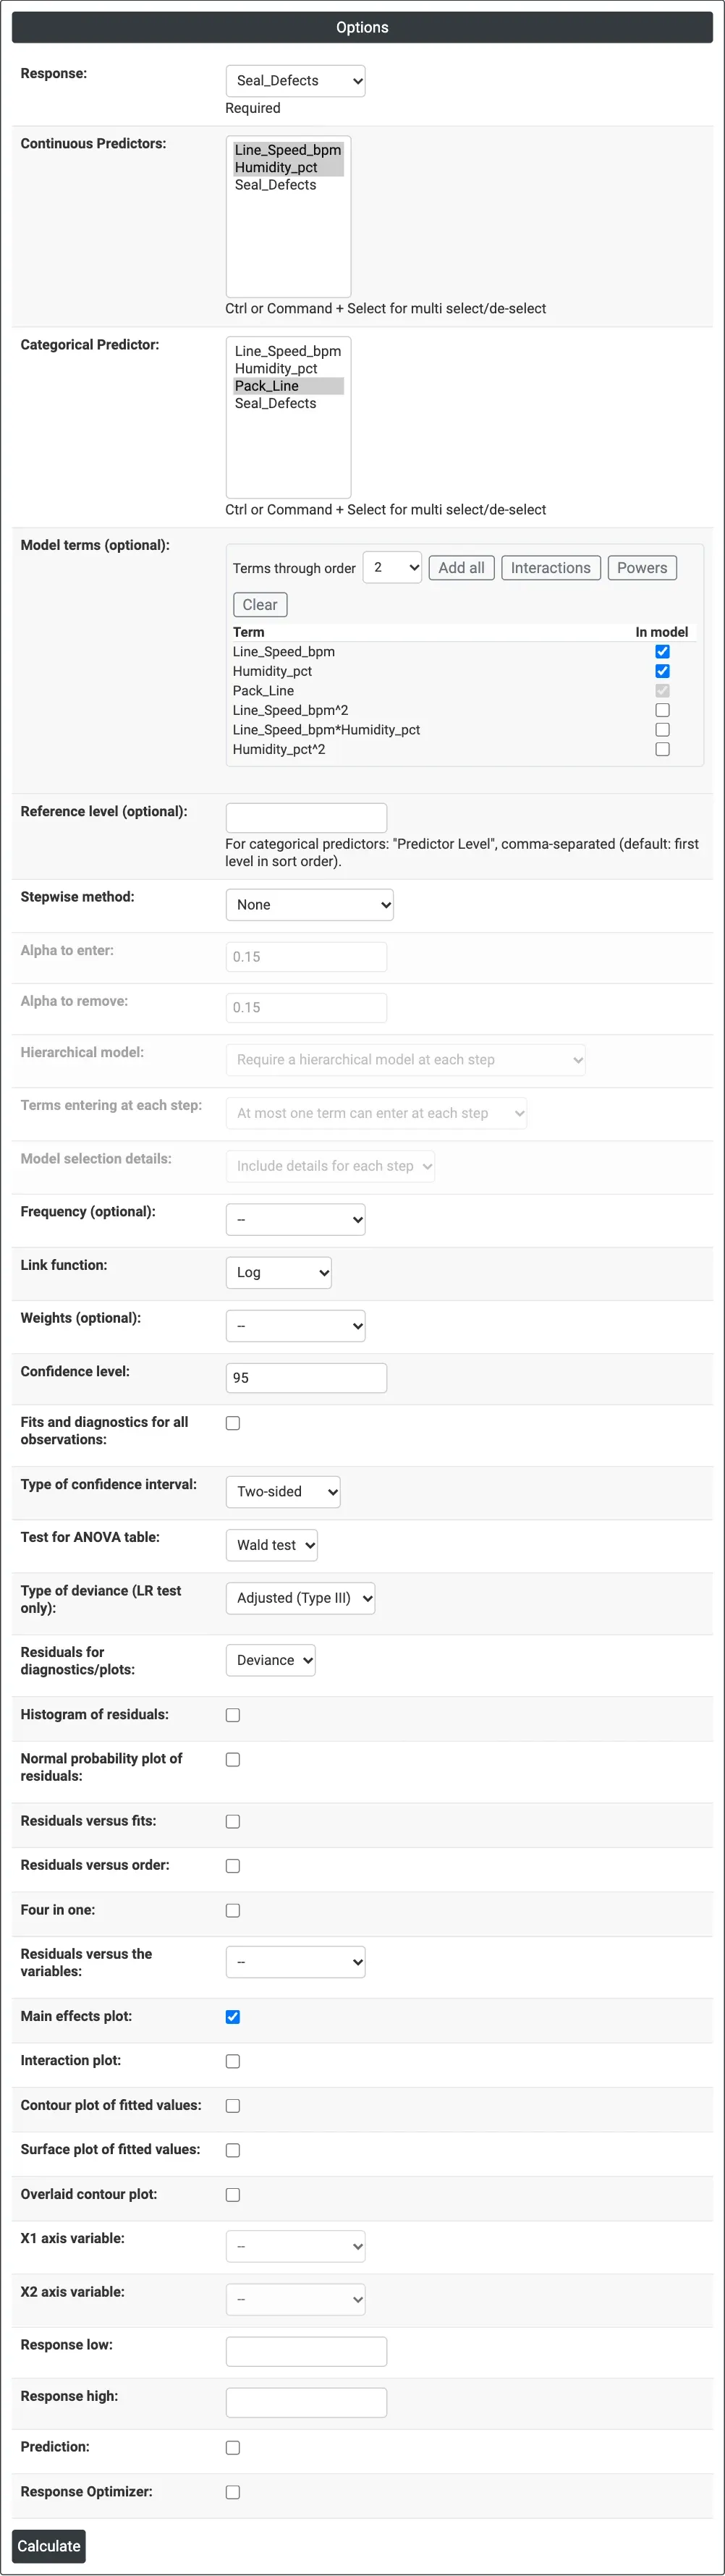
图 1 — 包装袋封口示例的选项:以 Seal_Defects 作为响应,线速度和湿度作为连续型预测变量,包装线作为分类预测变量,并勾选主效应图。
输出说明
- Method — 连接函数、分类编码和所用行数。
- Response Information — 计数的 N、均值、标准差、最小值和最大值。
- Coefficients — Coef、SE Coef、Z-Value、P-Value、置信限和 VIF。
- Regression Equation — 分类预测变量每个水平对应的线性预测值 Y'(采用对数连接函数时为期望计数的自然对数)。
- Model Summary — deviance R-Sq、Adj R-Sq、AIC、AICc 和 BIC。
- Goodness-of-Fit Tests — 偏差检验和 Pearson 卡方检验。
- Fits and Diagnostics for Unusual Observations(异常观测值的拟合与诊断)。
- Analysis of Deviance — 回归和每一项的卡方与 p 值。
- 所选时还包括 Stepwise selection 表、残差图、析因图、等高线图和曲面图,以及预测和优化器面板。
- 通过 Download 导出 PDF。
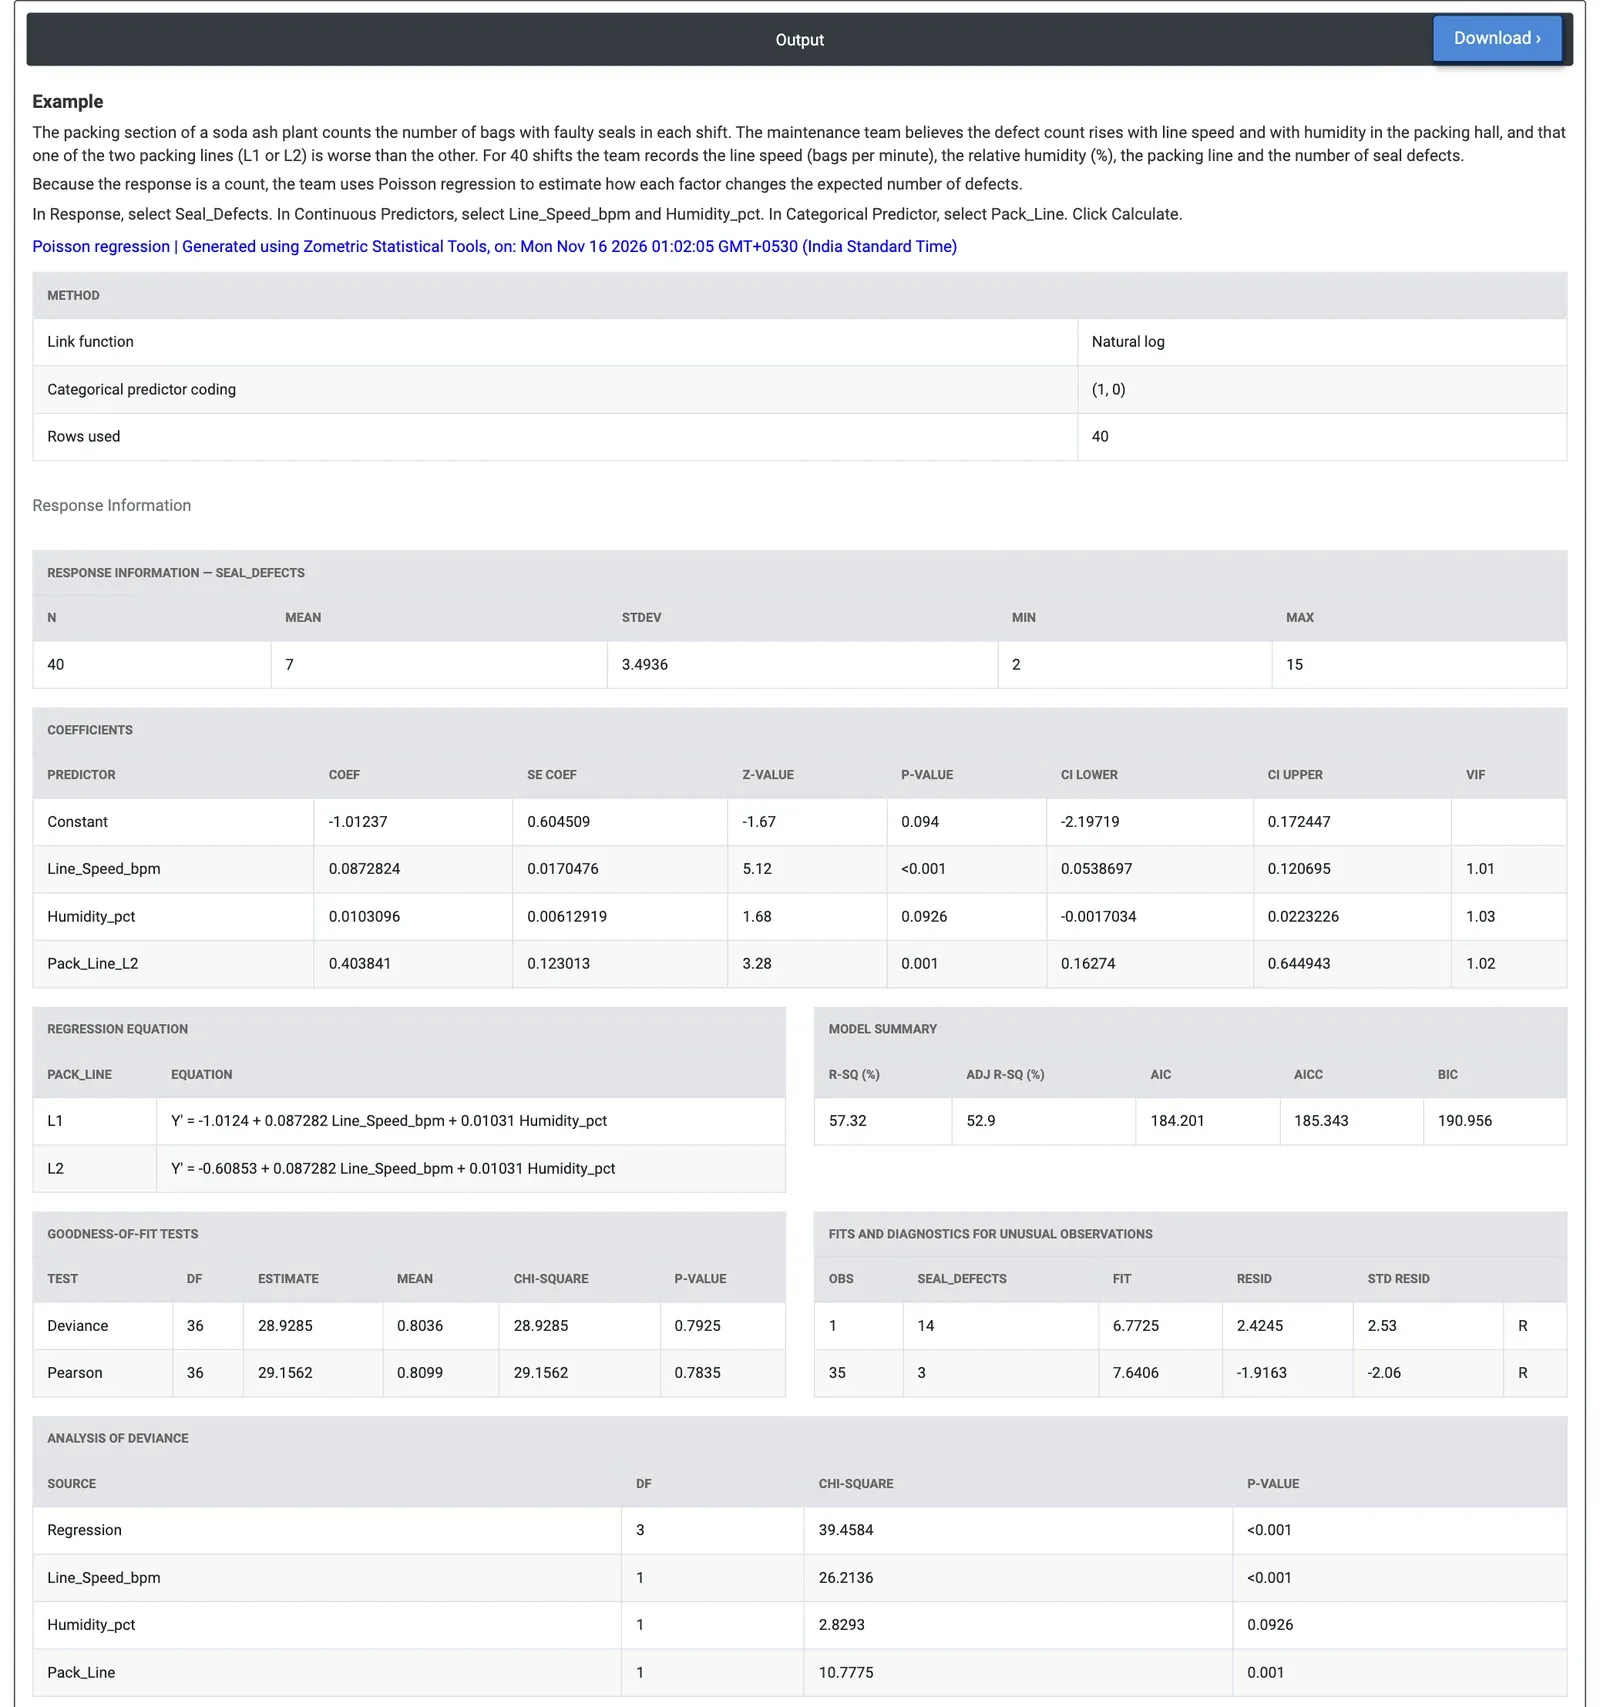
图 2 — 每班封口缺陷数的泊松回归:线速度(p < 0.001)和包装线(p = 0.001)有影响,湿度在 5% 水平上无影响(p = 0.0926)。
计算示例
某纯碱厂的包装工段统计每班封口有缺陷的袋数。对于 40 个班次,团队记录了线速度(每分钟袋数)、包装车间湿度(%)、包装线(L1 或 L2)以及封口缺陷数(2 至 15,均值 7)。他们选择 Seal_Defects 作为响应,线速度和湿度作为连续型预测变量,Pack_Line 作为分类预测变量,并保持对数连接函数。
线速度的影响最强(Wald 卡方 26.21,p < 0.001):其系数 0.0873 表示每分钟每多一袋,期望缺陷数乘以 exp(0.0873) = 1.09,每分钟快 5 袋则约乘以 1.55。包装线 L2 的系数为 0.404(p = 0.001),因此在相同速度和湿度下,其产生的封口缺陷数约为 L1 的 1.50 倍。湿度的方向相同(相对湿度每增加 10%,缺陷约增加 11%),但在 5% 水平上不显著(p = 0.0926)。
该模型对计数拟合良好:偏差卡方 28.93,自由度 36(p = 0.7925),Pearson 为 29.16(p = 0.7835),Mean 小于 1,因此没有过度离散的迹象。有两个班次被标记:班次 1 缺陷数为 14,而拟合值为 6.8;班次 35 缺陷数为 3,而拟合值为 7.6。团队首先检查 L2 的封口夹爪和速度设定值,并在决定是否除湿之前继续收集湿度数据。
常见问题
何时应使用泊松回归而不是普通最小二乘回归?
当响应是固定时间、面积或产品数量内的事件计数(如每班缺陷数或每月故障次数)时,使用泊松回归。计数不能为负,且其离散程度随均值增大,而最小二乘回归并未考虑这一点。泊松回归将其作为用最大似然法拟合的广义线性模型来处理。
如何解读泊松回归的系数?
采用默认的对数连接函数时,期望计数的自然对数等于 b0 + b1x1 + ...,因此预测变量每增加一个单位,每个系数会使期望计数乘以 exp(b)。例如,线速度系数为 0.0873,表示每分钟每多一袋,期望缺陷数乘以 exp(0.0873) = 1.09。分类预测变量相对于参考水平进行比较。
如何检查泊松回归中的过度离散?
拟合优度检验将偏差和 Pearson 卡方与误差自由度对应的卡方分布进行比较。p 值较小,或 Mean(偏差除以 DF)远大于 1,表示计数的变异超出了泊松模型所允许的范围。此时模型各项的 p 值会偏小,不应轻信。
泊松回归中如何标记异常观测值?
标准化残差超出正负 2 的观测值标记为 R,杠杆值大于 3p/n 的观测值标记为 X。它们列在 Fits and Diagnostics for Unusual Observations 表中,还可以添加残差与拟合值图、残差正态概率图等残差图,以进一步考察这些观测值。