
单样本 Z 检验的功效与样本量
在标准差已知(例如来自长期稳定的控制图历史)时,规划对单个均值的单样本 Z 检验。输入样本量、差值和功效中的任意两项,以及已知标准差,工具即用闭式正态公式求解第三项,并输出含实际功效的结果表和功效曲线。如果标准差需由样本估计,请使用单样本 t。
最后审阅
核心要点
单样本 Z 的功效与样本量用于在过程标准差已知时规划单个均值与目标值的检验,可求解样本量、功效或最小可检测差值。
用途
单样本 Z 的功效与样本量用于在过程标准差已知(例如来自长期稳定的控制图历史)时,规划单个均值与目标值的检验。它回答需要多少次测量才能检出有意义的偏移、计划的样本能达到多大功效,或给定样本能检出的最小偏移。输入样本量、差值和功效中的任意两项,工具即求解第三项。请在进行单样本 Z 检验之前使用;如果标准差需由样本估计,请改用单样本 t 的功效与样本量。
主要功能
- 求解样本量、功效或差值:将需要求解的一项留空。
- 可一次输入多个值,例如样本量“10 20 30”,每种组合各给出一行。
- 双侧(Mean ≠ hypothesized mean)或单侧(Mean < hypothesized mean、Mean > hypothesized mean)备择假设,置信水平可自选。
- 采用闭式正态计算,因此在标准差已知时结果是精确的。
- 针对每个差值绘制功效随样本量变化的功效曲线,并标出求解的点。
统计方法
检验统计量为 Z = (x̄ − μ₀) / (σ/√n),σ 视为已知,因此整个计算都使用标准正态分布。显著性水平为 α = 1 − 置信水平 / 100,标准化差值为 d = 差值 / σ(差值为真实均值减去 μ₀),z 在双侧备择假设时为 z₁₋α/₂,单侧时为 z₁₋α。
对于双侧检验,功效 = Φ(|d|·√n − z) + Φ(−|d|·√n − z);对于 Mean > hypothesized mean,功效 = Φ(d·√n − z),对于 Mean < hypothesized mean,功效 = Φ(−d·√n − z),因此当差值位于错误一侧时,单侧检验的功效接近 0。达到目标功效所需的样本量为 n = ((z + z_β) / d)²,其中 z_β 为目标功效的正态分位数;n 向上取整,并将该整数对应的功效作为实际功效报告。给定 n 和功效时,最小可检测差值为 σ·(z + z_β)/√n,对于“小于”备择假设则报告为负差值。
由于不估计 σ,在相同样本量下,Z 计算得到的功效略高于 t 计算,小样本时尤为明显。仅当标准差确实已知且稳定时才使用它。对于单侧备择假设,如果根据位于错误一侧的差值求解样本量,则会返回错误信息。
输入字段和选项
字段 | 说明 |
Sample sizes | 以空格或逗号分隔,例如“10 20 30”。留空则求解样本量。 |
Differences | 以空格或逗号分隔,例如“1 2 3”。与假设均值相比要检出的差值。留空则求解差值。 |
Power values | 以空格或逗号分隔,例如“0.8 0.9”。留空则求解功效。 |
Known standard deviation | 必填。总体标准差,假定已知(不由样本估计)。 |
Confidence level | 默认为 95(α = 0.05);范围 75 至 100。 |
Alternative hypothesis | Mean ≠ hypothesized mean(默认)、Mean < hypothesized mean 或 Mean > hypothesized mean。 |
Power curve | 默认勾选:绘制功效随样本量变化的曲线。 |
Title | 显示在输出和功效曲线上的标题。 |
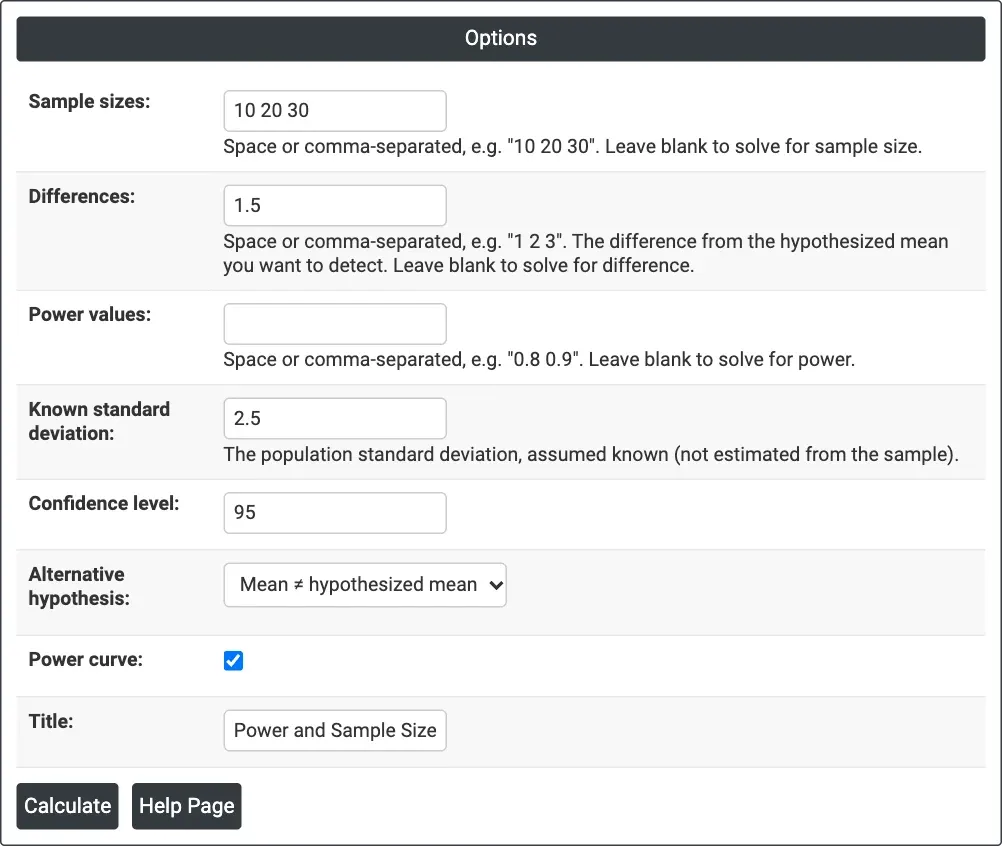
图 1 — 求解功效:Sample sizes = 10 20 30,Differences = 1.5,Known standard deviation = 2.5,95% 置信水平下双侧。
输出说明
- Settings — 所求解的项、已知标准差、置信水平和备择假设。
- Results — 每种组合一行:求解功效时为差值、样本量和功效;求解样本量时为目标功效和实际功效;求解差值时为差值。
- Power Curve — 针对每个差值绘制功效随样本量变化的曲线,并标出计算得到的点。
- 通过 Download 导出 PDF。
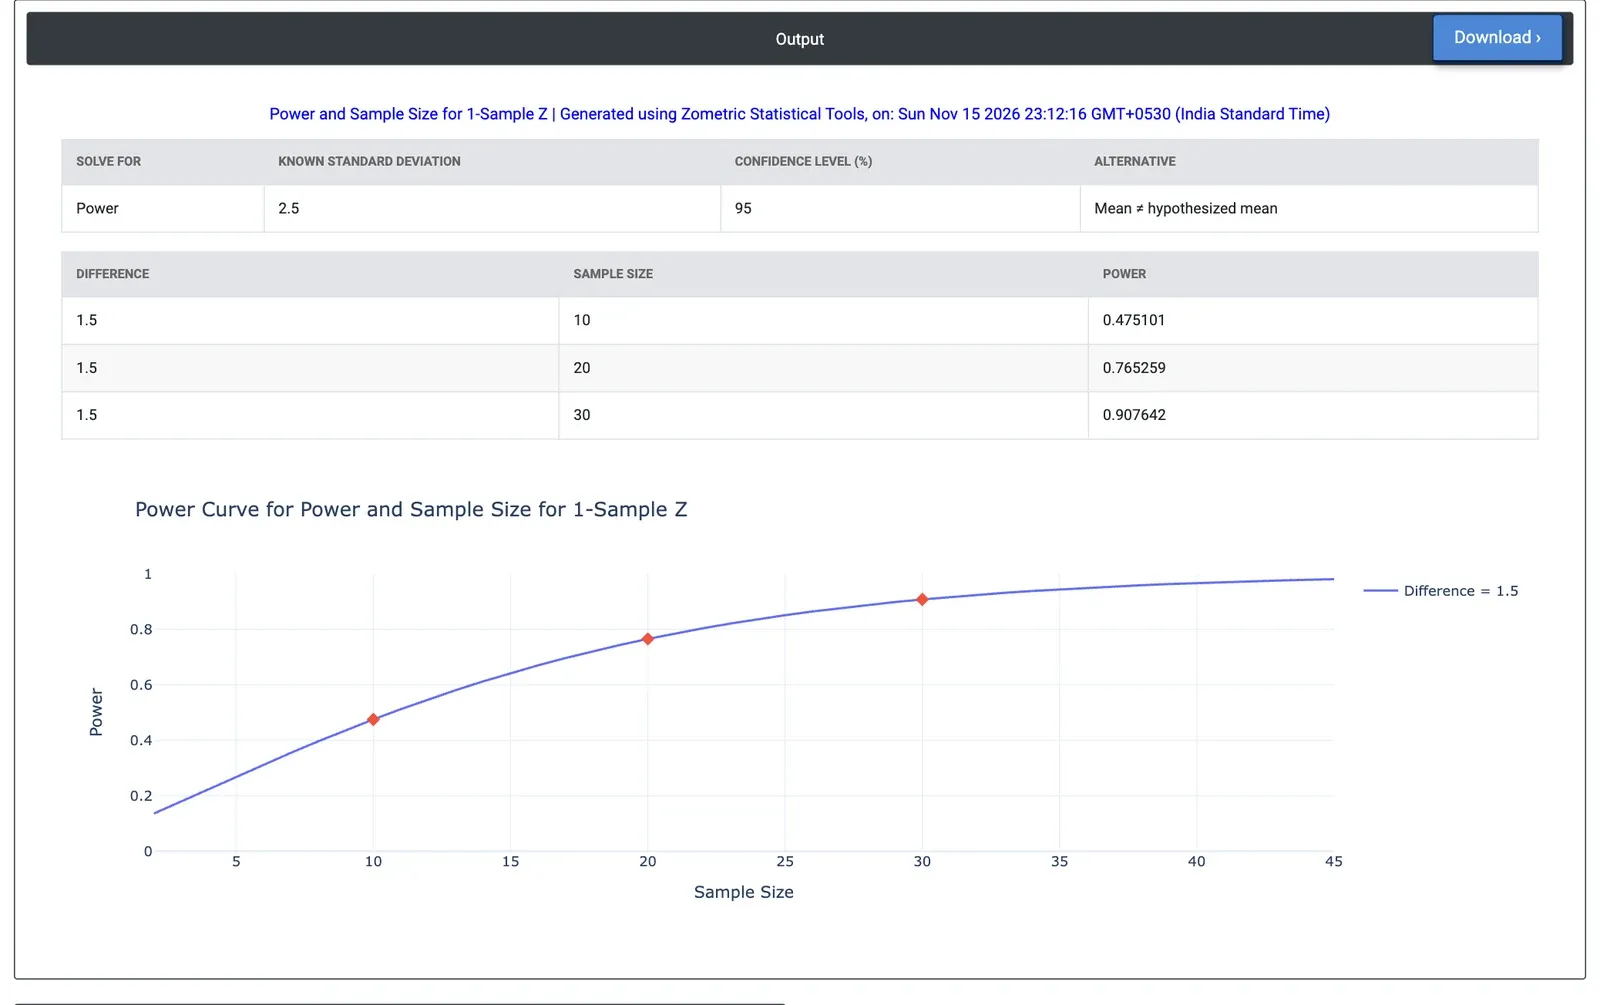
图 2 — 示例结果:偏移 1.5 g 时,10、20 和 30 包对应的功效分别为 0.475、0.765 和 0.908。
计算示例
一家食品包装企业对 250 g 包装的平均重量进行审核。多年的稳定控制图数据表明标准差为 2.5 g,因此将其视为已知。向任一方向偏移 1.5 g 都会造成影响,审核团队希望比较 10、20 和 30 包的样本。他们输入 Sample sizes = 10 20 30、Differences = 1.5 和 Known standard deviation = 2.5,将 Power values 留空,并保持 95% 置信水平下的双侧备择假设。
10 包时功效为 0.475,20 包时为 0.765,30 包时为 0.908。10 包的审核有一半以上的概率会漏掉真实的 1.5 g 偏移,因此团队改用 30 包;以 Power values = 0.9 求解样本量,确认 30 包是达到 90% 功效的最小样本量。20 包、功效为 80% 时,可检测的最小偏移为 1.57 g。如果标准差由每个样本估计(即单样本 t 计算),功效会更低:分别为 0.396、0.721 和 0.888。
常见问题
何时应使用单样本 Z 功效计算而不是单样本 t?
仅当过程标准差确实已知且稳定(例如来自多年的控制图数据)时,才使用 Z 计算。如果标准差需由样本估计,请使用单样本 t 的功效与样本量。由于不估计标准差,在相同样本量下,Z 的功效略高于 t,小样本时尤为明显。
单样本 Z 检验的样本量公式是什么?
达到目标功效所需的样本量为 n = ((z + z_beta) / d) 的平方,其中 d 为差值除以已知标准差,z 为所选备择假设对应的临界值,z_beta 为目标功效的正态分位数。结果向上取整,并将该整数对应的功效作为实际功效报告。
如何求最小可检测差值?
对于给定的样本量和功效,最小可检测差值等于标准差乘以 (z + z_beta) 再除以 n 的平方根。对于“小于”备择假设,则报告为负差值。在已知标准差为 2.5 g 的计算示例中,20 包、功效 80% 时可检测 1.57 g 的偏移。
样本量如何影响单样本 Z 检验的功效?
功效随样本量增大而提高。在已知标准差为 2.5 g、偏移 1.5 g、95% 置信水平下双侧的计算示例中,10 包时功效为 0.475,20 包时为 0.765,30 包时为 0.908。如果改为估计标准差(如单样本 t 计算),则功效更低,分别为 0.396、0.721 和 0.888。