
配对等价检验的功效与样本量
用于规划配对等价检验:每个单元被测量两次(例如用新量具和参考量具),且必须证明均值差小到可以忽略。输入等价限、配对差值的标准差,以及配对数、差值和功效三者中的任意两项;工具使用精确的 TOST 功效求解第三项。输出结果表和功效曲线。
最后审阅
核心要点
配对等价检验的功效与样本量用于计算需要多少对数据,才能通过两个单侧 t 检验(TOST)证明配对差值的均值落在等价区间内。
用途
配对等价检验的功效与样本量用于规划这样一类研究:每个单元被测量两次,例如用新方法和参考方法、过程变更前后,或在两个夹具上测量,目的是证明配对差值的均值小到可以忽略。设定均值差的等价区间后,工具会告知需要多少对数据、计划的配对数能带来多大的功效,或者可以容忍多大的真实差值。输入样本量、差值和功效三者中的任意两项,工具即可求解第三项。请在进行配对等价检验之前使用。
主要功能
- 可求解样本量(配对数)、功效或差值:留空您想求解的那一项。
- 可一次输入多个值,例如样本量“10 20 30”,每种组合各得一行。
- 任意等价区间,对称或不对称均可。
- 对配对差值的两个单侧检验(TOST)程序给出精确功效。
- 每个差值对应的功效对配对数的功效曲线,并标出求解得到的点。
统计方法
配对研究通过每一对内部的差值(测试 − 参考)进行分析,因此该计算是应用于这些差值的单样本 TOST。对于 n 对数据和差值的标准差 σ_d,标准误为 SE = σ_d/√n,自由度为 n − 1。当证明均值差高于下限 L 且低于上限 U 时,即判定等价,其中每个单侧 t 检验的显著性水平为 α(即 Significance level (alpha) 字段,默认值 0.05)。
功效是真实均值差为 δ 时两个单侧检验均成功的概率。它是精确计算的:对于给定的差值样本标准差 s,成功的概率为 Φ(−t·s/σ_d − (δ − U)/SE) − Φ(t·s/σ_d − (δ − L)/SE),其中 t = t₁₋α,n−1,并通过数值积分对样本方差的卡方分布取平均。对于样本量,找到达到目标功效的配对数并向上取整,该数目下的功效作为实际功效报告。求解差值时,工具在两个限值的中点与上限之间搜索。
应输入的标准差是配对差值的标准差,而不是单个测量值的标准差。当单元上的两次测量密切相关时,配对会带来收益,因为此时 σ_d 远小于单元之间的离散程度。差值必须严格位于两个限值之间;功效在区间的中点处最高。
输入字段和选项
字段 | 说明 |
Sample sizes | 配对数。以空格或逗号分隔,例如“20 30 40”。留空则求解样本量。 |
Difference(s) to detect | 以空格或逗号分隔,例如“0.5 0.7”。您预期的真实配对差值均值;必须严格位于两个限值之间。留空则求解该值(在两个限值的中点与上限之间搜索)。 |
Power values | 以空格或逗号分隔,例如“0.8 0.9”。留空则求解功效。 |
Lower equivalence limit / Upper equivalence limit | 必填。可接受的最小和最大均值差;下限必须小于上限。 |
Standard deviation of the differences | 必填。配对差值的假定或历史标准差。 |
Significance level (alpha) | 默认值为 0.05。应用于两个单侧检验中的每一个。 |
Power curve | 默认勾选:绘制功效对样本量的曲线。 |
Title | 输出和功效曲线上显示的标题。 |
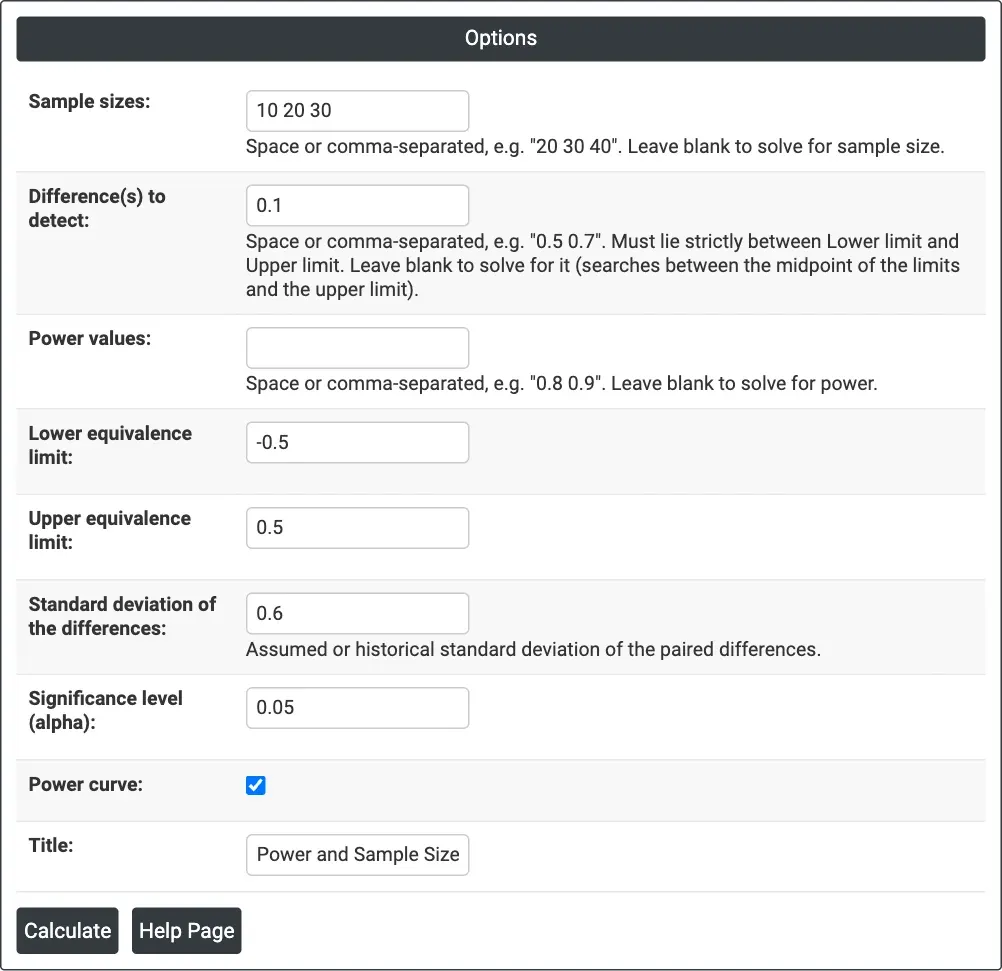
图 1 — 求解功效:Sample sizes = 10 20 30,Difference(s) to detect = 0.1,限值为 −0.5 和 0.5,Standard deviation of the differences = 0.6,alpha = 0.05。
输出说明
- Settings — 求解的对象、等价下限和上限、差值的标准差以及显著性水平。
- Results — 每种组合一行:差值、样本量(配对数),求解功效时给出功效,求解样本量时给出目标功效和实际功效,求解差值时给出差值。
- Power Curve — 每个差值对应的功效对样本量的曲线,并标出计算得到的点。
- 通过 Download 导出 PDF。
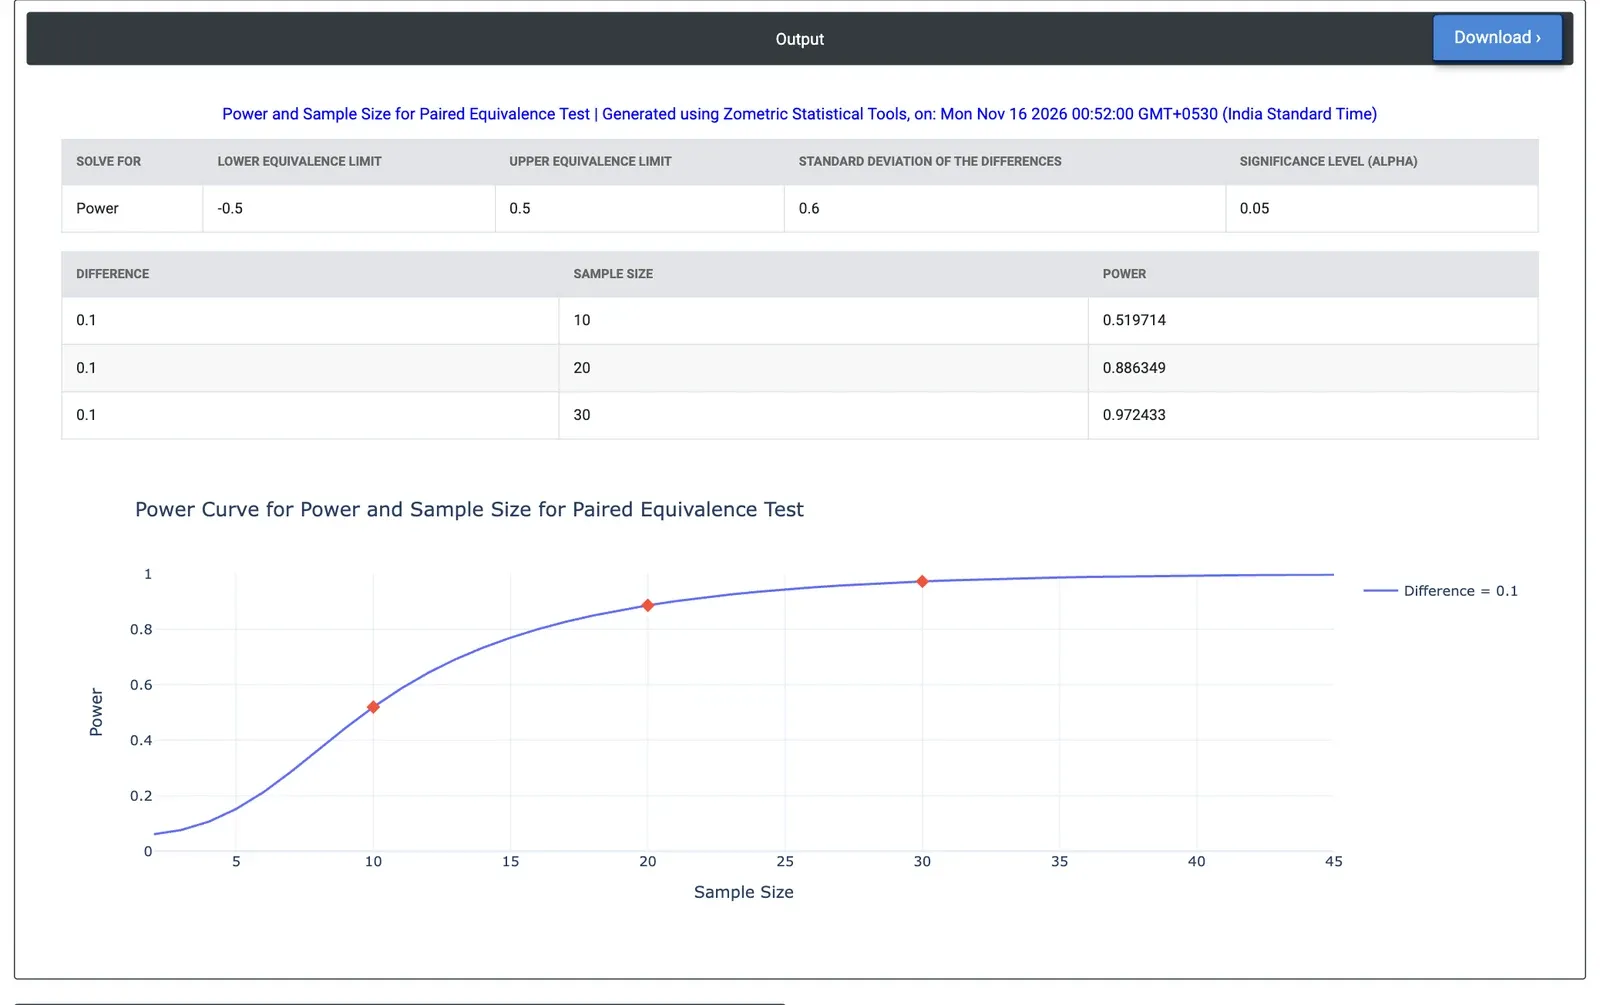
图 2 — 示例的结果:当真实偏倚为 0.1 µm、等价区间为 ±0.5 µm 时,10、20 和 30 块面板的功效分别为 0.520、0.886 和 0.972。
计算示例
某涂装车间想用更便宜的手持设备替换其参考涂层测厚仪。每块试验面板将用两台量具分别测量,若手持量具的均值偏倚在 ±0.5 µm 以内,则可接受。一次试运行得到配对差值的标准差为 0.6 µm,预期偏倚约为 0.1 µm。计量人员输入 Sample sizes = 10 20 30,Difference(s) to detect = 0.1,Lower equivalence limit = −0.5,Upper equivalence limit = 0.5,Standard deviation of the differences = 0.6,Power values 留空,并保持 alpha = 0.05。
10 块面板的功效为 0.520,20 块为 0.886,30 块为 0.972。10 块面板意味着有大约二分之一的机会误判一台实际上可接受的量具为不合格。改为求解样本量(Power values = 0.8 0.9),则 80% 功效需要 16 块面板,90% 需要 21 块。如果偏倚为 0.2 µm,20 块面板的功效为 0.695;若完全没有偏倚,则为 0.948。
常见问题
配对等价功效分析如何计算?
配对研究通过每一对内部的差值(测试减参考)进行分析,因此该计算是应用于这些差值的单样本 TOST。当证明均值差高于下限且低于上限时,即判定等价,其中每个单侧 t 检验采用所选的 alpha。功效通过数值积分精确计算。
进行配对等价检验时应输入哪个标准差?
输入配对差值的标准差,而不是单个测量值的标准差。当单元上的两次测量密切相关时,配对会带来收益,因为此时差值的标准差远小于单元之间的离散程度,从而减少所需的配对数。
配对等价检验需要多少对数据?
在一个计算示例中,等价区间为正负 0.5 微米,差值的标准差为 0.6,预期偏倚为 0.1,16 块面板可达 80% 功效,21 块可达 90%。10 块面板的功效为 0.520,20 块为 0.886,30 块为 0.972。更大的偏倚 0.2 会使 20 块面板的功效降至 0.695。
为什么差值必须严格位于等价限之间?
位于限值上或超出限值的真实均值差永远无法被证明等价,因此预期差值必须严格位于下限和上限之间。真实差值位于区间中点时功效最高,向任一限值靠近时功效下降。