
随机数据
随机数据从 26 种分布之一(包括 Normal、Lognormal、Weibull、Triangular、Binomial、Poisson 和 Multivariate Normal)中抽取 10 到 10,000 行、最多 10 个独立列的数据。数值的抽取没有固定种子,因此每次运行都会得到新的数字。可选的舍入以及包含直方图、Anderson-Darling 正态性检验、置信区间和概率图的图形汇总,可用于描述所生成的数据。
最后审阅
核心要点
随机数据可从 26 种连续、离散或多元正态分布中的任意一种生成随机数,并放入数据窗格,用于培训数据、模拟、假设情景研究,以及观察样本的变异程度。
用途
随机数据从 26 种分布之一生成随机数,并放入数据窗格,可直接复制或用于其他工具。可用它制作培训用的练习数据,观察来自已知过程的样本有多大的变异(来自理想正态过程的 30 个值的直方图很少呈钟形),在真实数据到来之前试用某项分析,或模拟某个过程进行假设情景研究,例如根据三角分布估计的周期时间,或根据威布尔模型得到的失效时间。可选的图形汇总用于描述所生成的数字。
主要功能
- Distribution 列表中共有 26 种分布:连续分布(Normal、Lognormal、Weibull、Exponential、Gamma、Uniform、Triangular 等)、离散分布(Binomial、Poisson、Geometric、Hypergeometric、Integer、Discrete 等)以及 Multivariate Normal。
- 仅显示所选分布的参数字段。
- 10 到 10,000 行,1 到 10 个独立列(data_1、data_2……)。
- 可选择将数值舍入到指定的小数位数。
- 可选的所有生成值的图形汇总:直方图、汇总统计量、Anderson-Darling 正态性检验、置信区间和概率图。
- Multivariate Normal:根据均值向量和协方差矩阵生成相关的列,并给出样本相关矩阵和协方差矩阵以供核对。
统计方法
数值使用 NumPy 和 SciPy 随机数生成器独立抽取,没有固定种子,因此每次 Calculate 都会得到新的数字。每一列都是来自同一分布、大小为所选值的单独样本。参数遵循通常的定义:例如 Normal(均值 μ,标准差 σ)、Weibull(形状 β,尺度 η,可选的阈值会加到每个值上)、Exponential(尺度 = 均值,可选阈值)、Integer(从 Minimum 到 Maximum 的整数,两端均包含)、Geometric(直到并包括首次事件为止的试验次数)和 Negative Binomial(达到所需事件数之前的非事件数)。对于 Lognormal,输入的是数据本身的均值和标准差:工具会将其转换为对数尺度参数 σ = √ln(1 + (s/m)²) 和 μ = ln(m) − σ²/2。对于 Discrete,各概率会重新缩放使其总和为 1。
勾选 Graphical Summary 后,所有列会合并为一个样本并加以描述:均值、标准差、方差、偏度、峰度、N、最小值、四分位数、中位数、最大值和变异系数(%);Anderson-Darling 正态性检验(A 平方和 p 值);均值(t)、中位数(Hettmansperger-Sheather)和标准差(卡方)的 95% 置信区间。勾选 Exclude outliers 后,落在 Q1 − 1.5×IQR 或 Q3 + 1.5×IQR 之外的值仅从汇总中剔除;所生成的数据仍保留这些值。对于 Multivariate Normal,协方差矩阵必须是方阵、对称、半正定,并且与均值的个数一致。
输入字段和选项
字段 | 说明 |
Distribution | 必填。26 种分布之一;下方的参数字段会随之变化。 |
Number of rows of data to generate | 必填,10 到 10,000。 |
Number of columns | 默认值为 1,最多 10。每列是一个独立样本。Multivariate Normal 不使用此项(每个均值对应一列)。 |
Graphical Summary | 默认不勾选。将所生成值的图形汇总添加到输出中。 |
Exclude outliers (1.5×IQR rule) | 可选。除非勾选了 Graphical Summary,否则不起作用;勾选后,仅从汇总中剔除异常值。 |
Decimals | 可选,0 到 10。对连续分布(Normal、Lognormal、Weibull、Exponential、T、F、Beta、Cauchy、Chi-Square、Gamma、Laplace、极值分布、Logistic、Loglogistic、Triangular 和 Uniform)所生成的值进行舍入。对于 Normal,至少保留足以显示标准差的小数位数。对于给出整数或列出值的分布(Binomial、Poisson、Bernoulli、Discrete、Geometric、Hypergeometric、Integer 和 Negative Binomial)以及 Multivariate Normal,不显示此项。 |
Mean / Standard Deviation | Normal;Lognormal(数据的均值和标准差);Poisson 仅使用 Mean。 |
Number of trials / Event probability | Binomial。仅 Event probability:Bernoulli 和 Geometric;与 Number of events (required successes) 一起使用:Negative Binomial。 |
Shape parameter / Scale parameter / Threshold parameter | Weibull(threshold 可选);Gamma 和 Loglogistic 使用 shape 和 scale。 |
Scale parameter / Threshold parameter | Exponential(threshold 可选)。 |
Location parameter / Scale parameter | Cauchy、Laplace、Largest Extreme Value、Smallest Extreme Value 和 Logistic。 |
Degrees of freedom / Numerator and Denominator degrees of freedom | T 和 Chi-Square;F。 |
First shape parameter / Second shape parameter | Beta。 |
Values / Probabilities | Discrete。以逗号或空格分隔,个数相同,例如“1 2 3”和“0.2 0.3 0.5”(如果总和不为 1,则重新归一化)。 |
Population size (N) / Event count in population / Sample size (n) | Hypergeometric。事件数和样本量不能超过总体大小。 |
Minimum / Maximum / Mode (most likely value) | Integer(minimum 和 maximum);Triangular(三项都需要,mode 介于二者之间)。 |
Lower endpoint / Upper endpoint | Uniform。 |
Means / Covariance matrix | Multivariate Normal。Means 每个变量一个,例如“10 20 30”;协方差矩阵的各行以分号分隔,例如“4,2,0; 2,9,1; 0,1,1”。 |
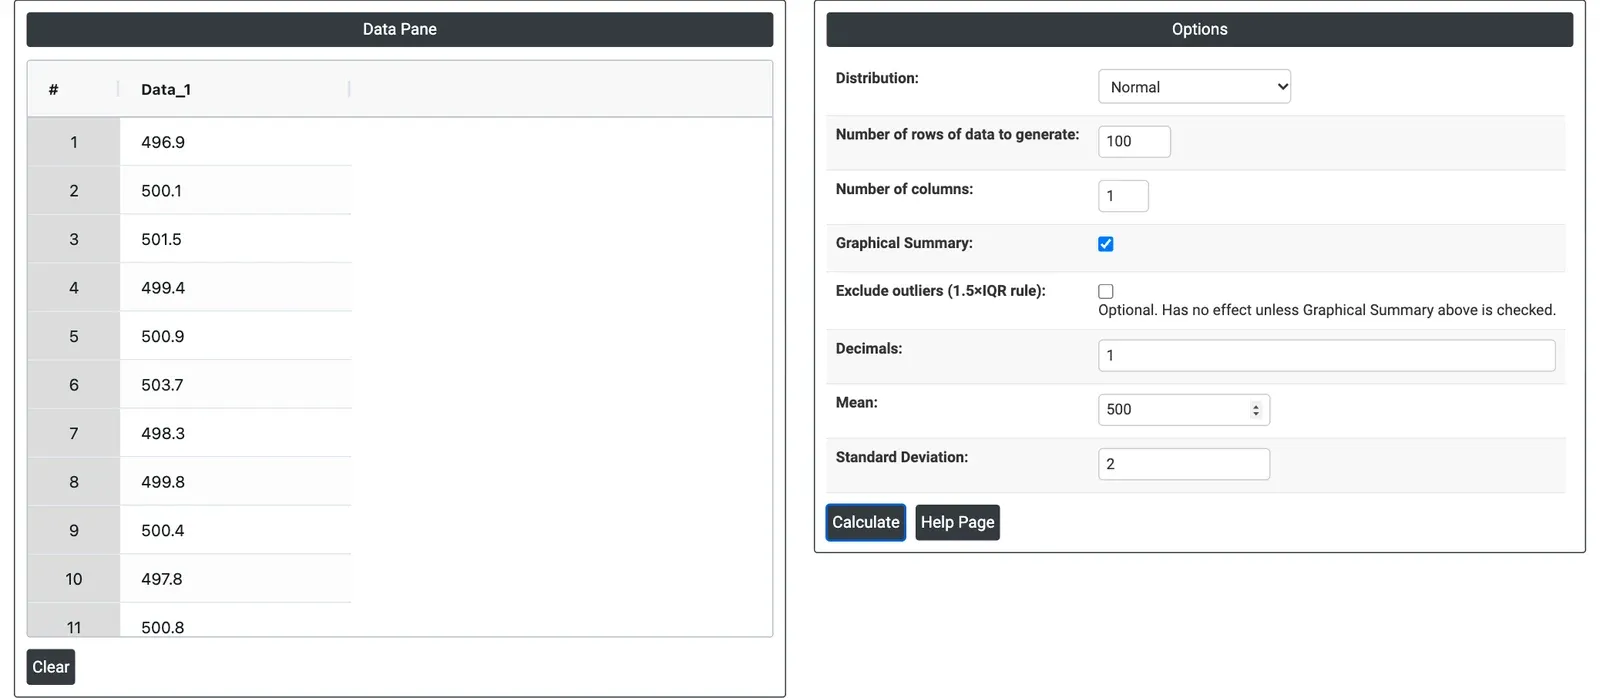
图 1 — 数据窗格(左)中来自均值为 500、标准差为 2 的 Normal 分布的 100 个值,舍入到 1 位小数,右侧为 Options。
输出说明
- Data Pane — 所生成的值,每个样本一列(data_1、data_2……),替换原有内容。
- Graphical summary(勾选时)— 带拟合正态曲线的直方图和箱线图;汇总表,包含 A-Squared、p-value、Mean、StDev、Variance、Skewness、Kurtosis、N、Minimum、1st Quartile、Median、3rd Quartile、Maximum 和 Coeff Var;均值和中位数的 95% Confidence Intervals 图;带 Anderson-Darling 结果的 Probability Plot;以及均值、中位数和标准差的 95% 下限和上限表,并给出每个区间的半宽。
- Multivariate Normal — 所生成各列的样本相关矩阵和协方差矩阵。
- 通过 Download as PDF 导出 PDF。
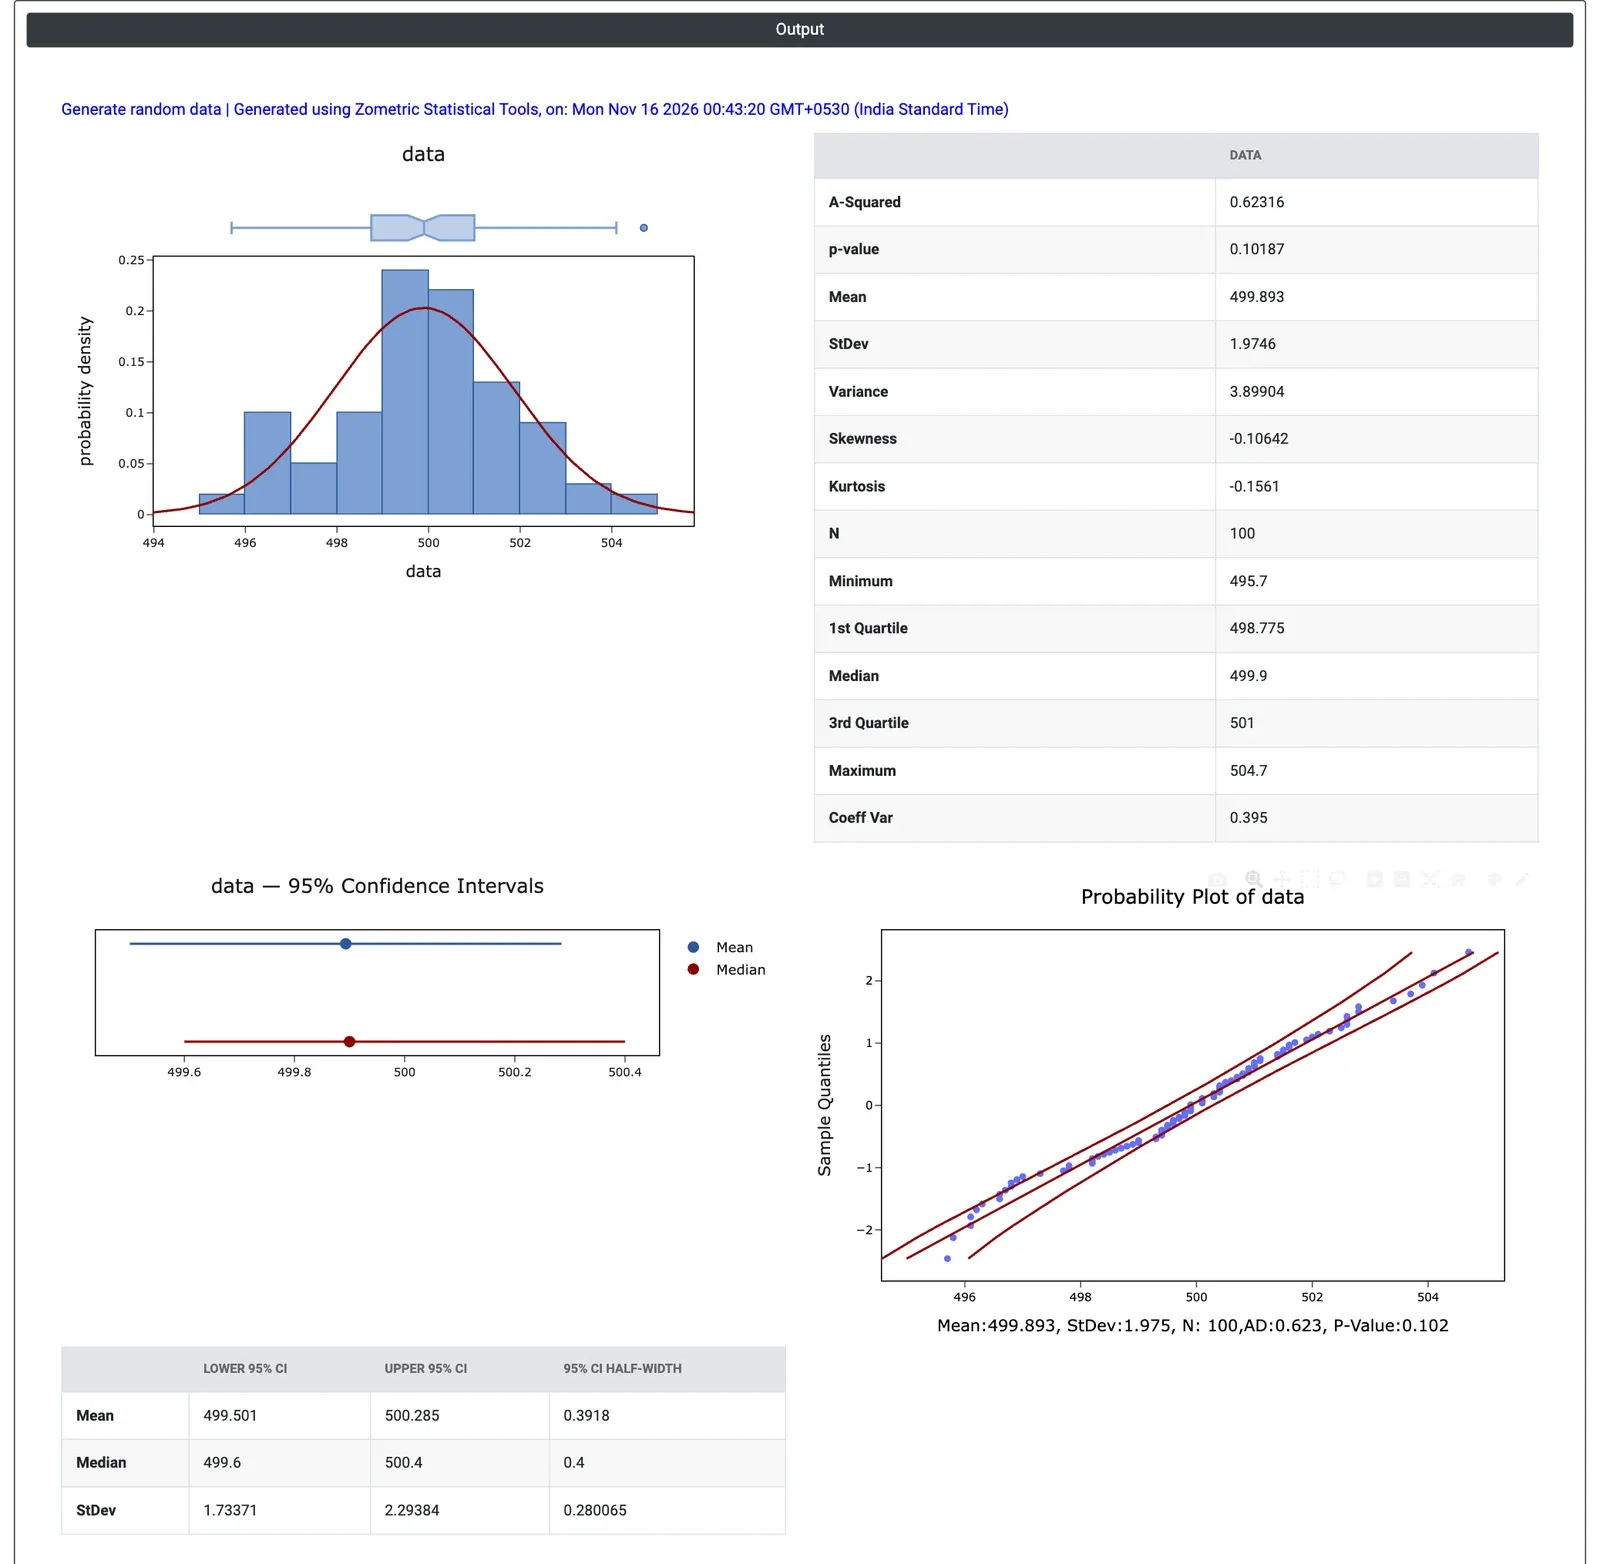
图 2 — 100 个生成值的图形汇总:均值 499.89,StDev 1.97,Anderson-Darling p 值 0.102。
计算示例
某质量培训师为灌装线操作员准备关于过程变异的培训课程。该生产线灌装 500 g 的瓶子,标准差约为 2 g。为了展示仅由正常变异造成的情形,培训师选择 Distribution = Normal、Number of rows = 100、Number of columns = 1、Mean = 500、Standard Deviation = 2 和 Decimals = 1,并勾选 Graphical Summary。
模拟的 100 个灌装重量介于 495.7 至 504.7 g 之间,均值为 499.89 g,标准差为 1.97 g,并不恰好是 500 和 2,尽管过程设定得完全精确。直方图参差不齐,并非整齐的钟形曲线,但 Anderson-Darling 检验给出 p = 0.102,因此没有证据表明数据不服从正态分布。均值的 95% 置信区间 499.50 至 500.29 g(半宽 0.39 g)包含真实值 500,标准差的区间 1.73 至 2.29 g 包含真实值 2。
要向操作员说明的要点是:一个稳定且居中的过程仍会产生偏离目标 4 g 的单个瓶子,以及与真实值不同的样本统计量。每次 Calculate 都会抽取新的样本,数字略有不同,培训师可借此展示样本之间的变异。生成 5 列、每列 20 行,可得到五个小样本供比较,也可以将数据复制到能力分析或控制图工具中进行练习。
常见问题
随机数据生成在质量工作中有什么用途?
它用于制作培训用的练习数据,观察来自已知过程的样本有多大的变异,在真实数据到来之前试用某项分析,以及模拟某个过程进行假设情景研究,例如根据三角分布估计的周期时间,或根据威布尔模型得到的失效时间。所生成的数据可复制到能力分析或控制图等其他工具中。
可以从哪些分布生成随机数据?
共有 26 种:连续分布,如 Normal、Lognormal、Weibull、Exponential、Gamma、Uniform 和 Triangular;离散分布,如 Binomial、Poisson、Geometric、Hypergeometric、Integer 和 Discrete;以及 Multivariate Normal,它根据均值向量和协方差矩阵生成相关的列。仅显示所选分布的参数字段。
为什么随机样本与总体均值和标准差并不完全一致?
每个样本都会因偶然因素而变化。在一个计算示例中,来自均值为 500、标准差为 2 的正态过程的 100 个值,样本均值为 499.89,标准差为 1.97,直方图参差不齐而非钟形,但 Anderson-Darling 检验给出 p = 0.102,表明没有证据显示数据不服从正态分布。
生成随机数据时如何输入对数正态分布的参数?
对于 Lognormal 分布,输入的是数据本身的均值和标准差,而不是对数的均值和标准差。工具会将其转换为对数尺度参数:sigma 等于 ln(1 + (s/m) 的平方) 的平方根,mu 等于 ln(m) 减去 sigma 的平方除以 2。