
1サンプルz検定(One sample z-test)
1サンプルz検定は、母集団の標準偏差が過去の調査や履歴データからわかっている場合に、標本平均を仮説の平均と比較します。データは連続値で、ランダムかつ独立であり、正規分布に従うか、サンプルサイズが20より大きく著しく歪んでいないことが必要です。標準偏差が不明な場合は、1サンプルt検定を使用します。出力にはz統計量、p値、信頼区間が含まれます。
最終レビュー
重要なポイント
1サンプルz検定は、母集団の標準偏差が既知の場合に、標準正規分布を用いて、標本平均が仮説の母平均と有意に異なるかどうかを判定します。
このページの内容
1サンプルz検定とは
1サンプルz検定は、標本の平均が既知の母平均と有意に異なるかどうかを判定するために使われる、推測統計の基本的な手順です。このパラメトリック検定は、母集団の標準偏差が既知であり、データ点が独立で、データが正規分布に従うか、標本平均がほぼ正規分布になるのに十分なサンプルサイズ(20より大きく、データが著しく歪んでいないこと)がある場合に適用できます。仮説検定において、1サンプル、2サンプル、比率のいずれにも適用できる汎用性があります。z検定は、データの性質と検定する仮説に応じて、左片側検定、右片側検定、両側検定に分類できます。この検定では、標準正規分布を用いて臨界値を計算し、標本平均を母平均と比較します。
1サンプルz検定は、標本平均が母平均より有意に大きいか、小さいか、または等しくないかを評価します。帰無仮説は、標本平均と母平均の間に有意な差がないというものです。検定統計量を計算して臨界値と比較し、棄却域に入った場合は帰無仮説を棄却します。
1サンプルz検定を使用する場面
一般に、1つの標本があり、それを既知の母集団の値と比較したい場合に使用します。
1サンプルz検定を使用するための条件:
- 母集団の標準偏差が既知であること:母集団の標準偏差(σ\sigmaσ)が既知である必要があります。
- サンプルサイズ:データが正規分布に従わない場合、サンプルサイズは20より大きく、データが著しく歪んでいてはいけません。
- 正規分布:標本の抽出元となる母集団は、特にサンプルサイズが小さい場合(20以下)、正規分布に従う必要があります。ただし、サンプルサイズが大きい場合、z検定は非正規性に対して頑健です。
- データ点が独立であること:標本内のデータ点は互いに独立でなければなりません。つまり、あるデータ点の値が別のデータ点の値に影響を与えないということです。
1サンプルz検定を使用するとよい場面の例を次に示します。
- 品質管理:工場でウィジェットを製造しており、その重量が顧客の仕様に合っているかどうかを知りたい場合です。この場合、ウィジェットのサンプルを採取して重量を測定し、顧客の仕様と比較できます。
- 医学研究:血圧を下げる新薬が開発され、その有効性を知りたい場合です。高血圧の患者のサンプルを採取して薬を投与し、一定期間後に血圧を測定します。その後、サンプルの平均血圧を母平均と比較できます。
- 顧客満足度:企業が、顧客が自社の製品に満足しているかどうかを知りたい場合です。この場合、企業は顧客をランダムにサンプリングし、満足度を1〜10の尺度で評価してもらいます。その後、サンプルの平均満足度スコアを母平均と比較できます。
1サンプルz検定を正しく使用するためのガイドライン
- 母集団の標準偏差が既知の場合は、1サンプルzを使用します
- 荷物の重量など、連続値のデータを解析に使用します
- 計数データには1サンプルポアソン率検定を、合格/不合格のようなデータには1サンプルの比率検定を使用します
- サンプルサイズは20より大きく、データが著しく歪んでいてはいけません
- サンプルデータをランダムに選び、各観測値が独立であることを確認します
- 精密な推定値と狭い信頼区間、および誤りに対する保護を確保できるよう、適切なサンプルサイズを決定します。
代替手法:1サンプルz検定を使用すべきでない場合
母集団の標準偏差がわからない場合は、1サンプルt検定を使用してください。
1サンプルz検定の例
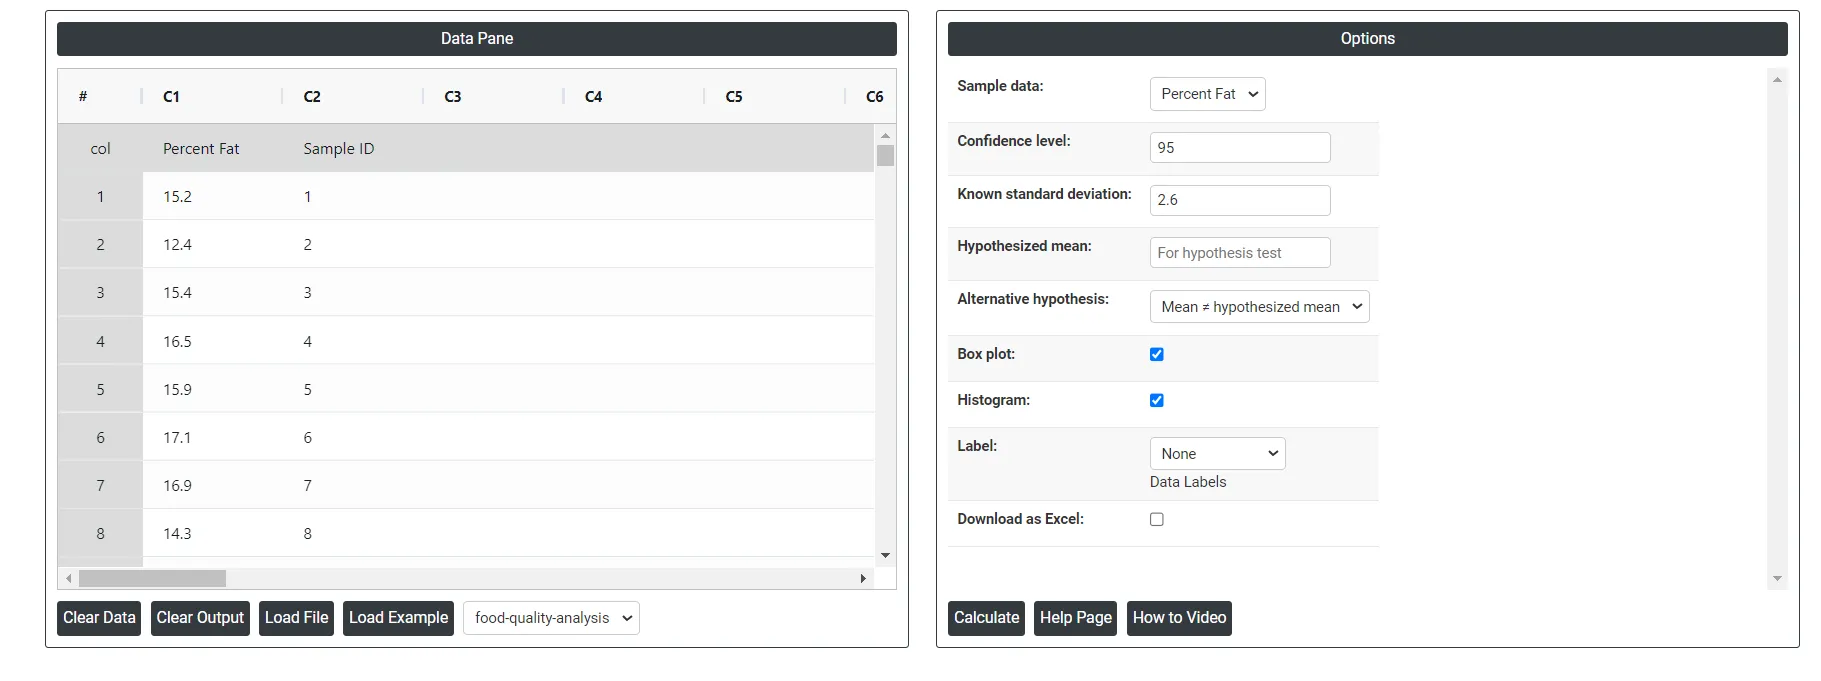
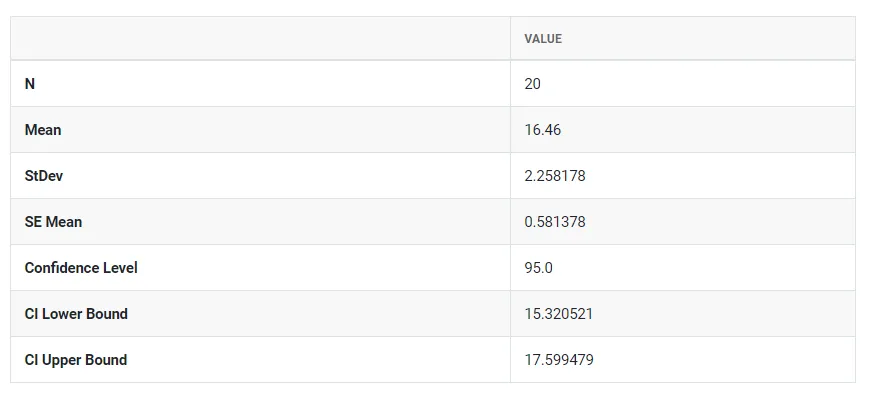
加工食品を製造する会社の科学者が、同社のボトル入りソースの脂肪の割合を評価したいと考えています。表示されている割合は15%です。科学者は、20個のランダムなサンプルについて脂肪の割合を測定します。以前の測定により、母集団の標準偏差が2.6%であることがわかっています。科学者は、脂肪の割合が15%と異なるかどうかを判定するために、1サンプルz検定を実行します。手順は次のとおりです。
- 必要なデータを収集しました。
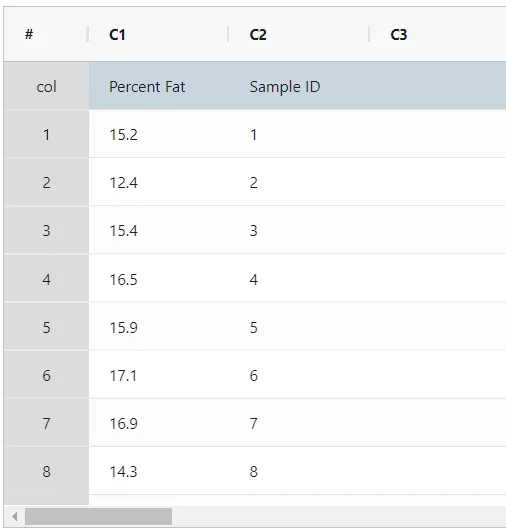
- 次に、Zometric Statistical Softwareでデータを解析します:https://statsai.zometric.com/。
- One sample z-testを見つけるには、Statistical module> Graphical analysis> One sample z-testを選択します。
- ツール内で、データとその他の入力を次のように入力します。
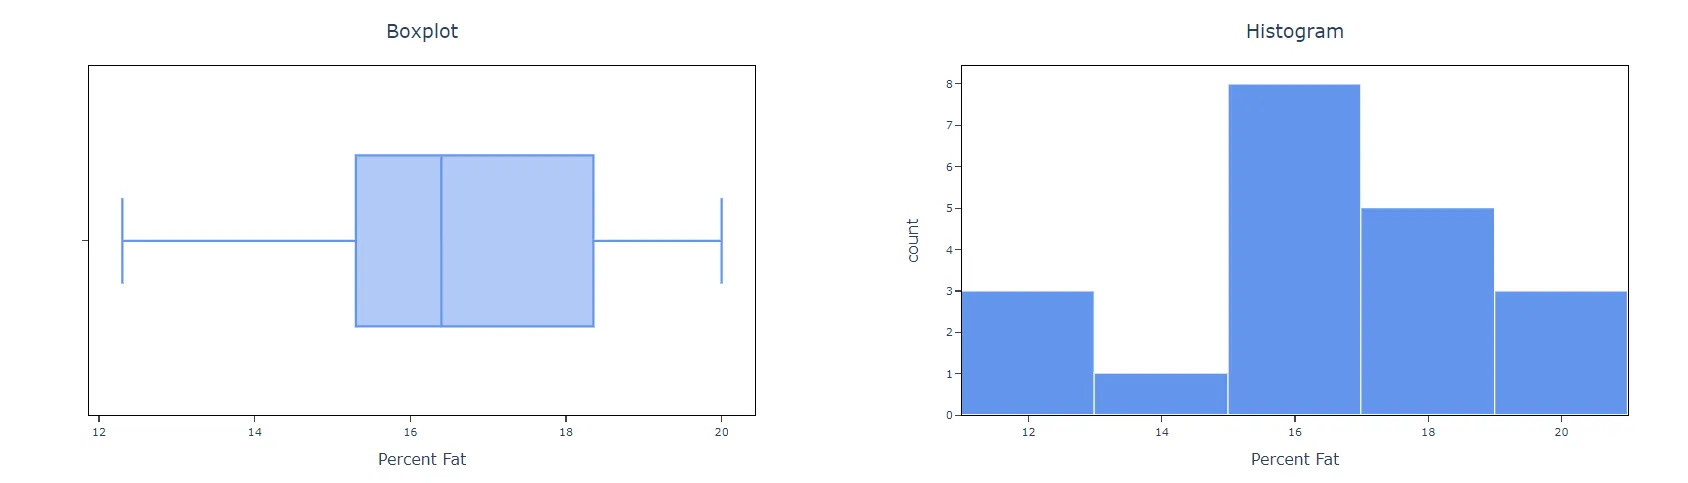
- 上記のツールを使用すると、次のような出力が得られます。
1サンプルz検定の実行方法
手順は次のとおりです。
- Zometric Statistical Softwareにログインします:https://statsai.zometric.com/
- ホームページで、Statistical Tool> Graphical analysis >One sample z-testを選択します。
- 次に、One sample z-test をクリックしてダッシュボードを開きます。
- 次に、データを手動で更新するか、Excelシートからデータをコピー(Ctrl+C)して、ここに貼り付け(Ctrl+V)ます。
- 次に、Confidence level、Known standard deviation、Hypothesized meanの値を入力します。
- 最後に、ページ下部のcalculateをクリックすると、目的の結果が得られます。
One sample z-testのダッシュボードでは、ウィンドウが2つの部分に分かれています。
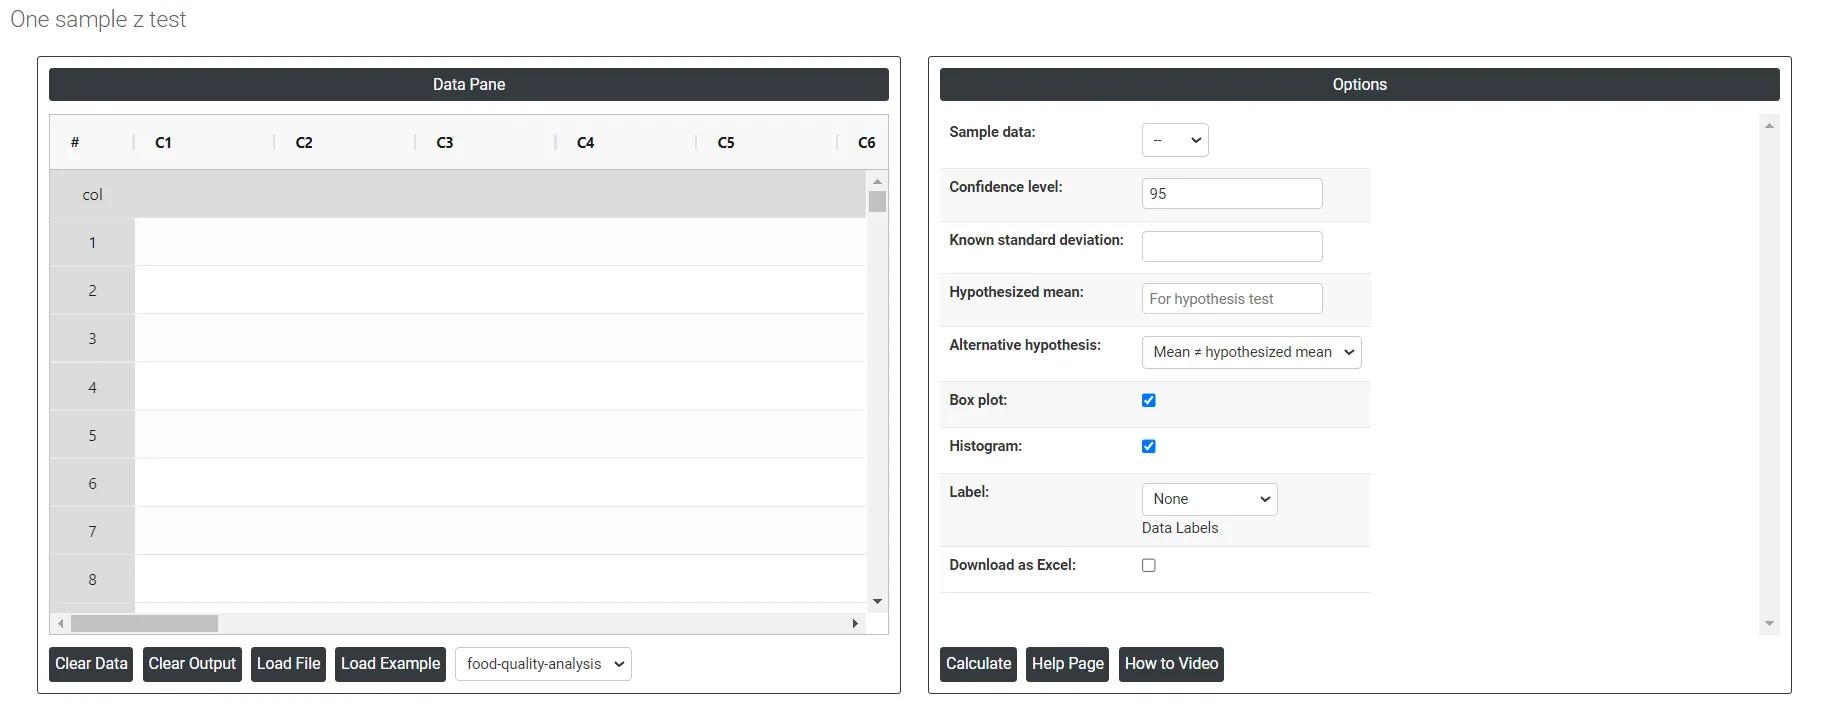
左側にはデータペイン(Data Pane)があります。Data Paneでは、各行が1つのサブグループになります。データを手動で入力するか、Excelシートからデータをコピー(Ctrl+C)して、ここに貼り付け(Ctrl+V)ます。
Load example: サンプルデータが読み込まれます。
Load File: Excelデータを直接読み込むために使用します。
右側には、次のような多くのオプションがあります。
- Confidence level: 仮説検定において、信頼水準は、統計解析に対する確実性の度合い、つまり信頼の水準を表します。これは、真の母集団パラメータが指定した値の範囲内にある可能性を示す確率値です。通常、信頼水準は百分率で表され、(1 - α) と書かれます。ここでαは有意水準、すなわち真の帰無仮説を棄却する確率です。たとえば、信頼水準が95%であれば、真の母集団パラメータが区間推定の中にあると95%の確信があり、第1種の誤り(真の帰無仮説を棄却すること)を犯す確率が5%あることを意味します。実用上、信頼水準が高いほど、統計解析とその結果への確信が高いことを意味します。ただし、信頼水準を上げると信頼区間の幅も広がり、小さな効果を検出しにくくなります。したがって、信頼水準の選択は、調査の状況と研究者の目的によって決まります。
- Known standard deviation: 標本から推定したものではなく、過去の調査や履歴データからわかっている母集団の標準偏差(σ)です。検定統計量zは、標本平均と仮説の平均との差を、平均の標準誤差(σをサンプルサイズの平方根で割ったもの)で割って計算し、標準正規分布と比較します。
- Hypothesized mean: 仮説平均は、期待される平均や母平均とも呼ばれ、帰無仮説で指定される、検定する変数の平均値を表す値です。これは理論上の値であり、実際の標本平均と比較して、その差が統計的に有意なのか、偶然によるものなのかを判断するために使用されます。
- Alternative hypothesis: 仮説検定において、対立仮説(研究仮説とも呼ばれます)は、帰無仮説とは異なる結論を表す記述です。帰無仮説は通常、現状、つまり2つ以上のグループまたは変数の間に有意な差や関係がないという仮定を表します。対立仮説は検定の対象となる記述であり、調べているグループまたは変数の間に有意な差や関係があると主張します。
- Box Plot: チェックを入れると箱ひげ図が表示されます。入れない場合は表示されません。
- Histogram: チェックを入れるとヒストグラムが表示されます。入れない場合は表示されません。
- Label: データラベルを設定します。次の3つの選択肢があります。
- Outlier:他のデータ値から大きく離れた値で、結果に強い影響を与えることがあります。
- All quartiles:四分位数は、データのサンプルを4つの等しい部分に分ける値です。データセットのばらつきと中心傾向をすばやく評価できます。
- Mean:箱ひげ図に平均を表示し、データの中心傾向に関する追加情報を提供します。
- Individual Data: 個別データ点は、データセット内の1つの観測値または値です。
- Download as Excel:結果をExcel形式で表示します。Excel形式は簡単に編集でき、load fileオプションを使って再読み込みし、計算に使用できます。
要約データを使った1サンプルz検定の実行方法
手順は次のとおりです。
- Zometric Statistical Softwareにログインします:https://statsai.zometric.com/
- ホームページで、Statistical Tool> Graphical analysis >One sample z-test for summarized dataを選択します。
- 次に、One sample z-test for summarized data をクリックしてダッシュボードを開きます。
- 次に、データを手動で更新するか、Excelシートからデータをコピー(Ctrl+C)して、ここに貼り付け(Ctrl+V)ます。
- 次に、Sample size、Sample mean、Known standard deviation、Hypothesized mean、Confidence levelの値を入力します。
- 最後に、ページ下部のcalculateをクリックすると、目的の結果が得られます。
One sample z-test for summarized dataのダッシュボードでは、ウィンドウは左側の部分のみです。
Load File: Excelデータを直接読み込むために使用します。
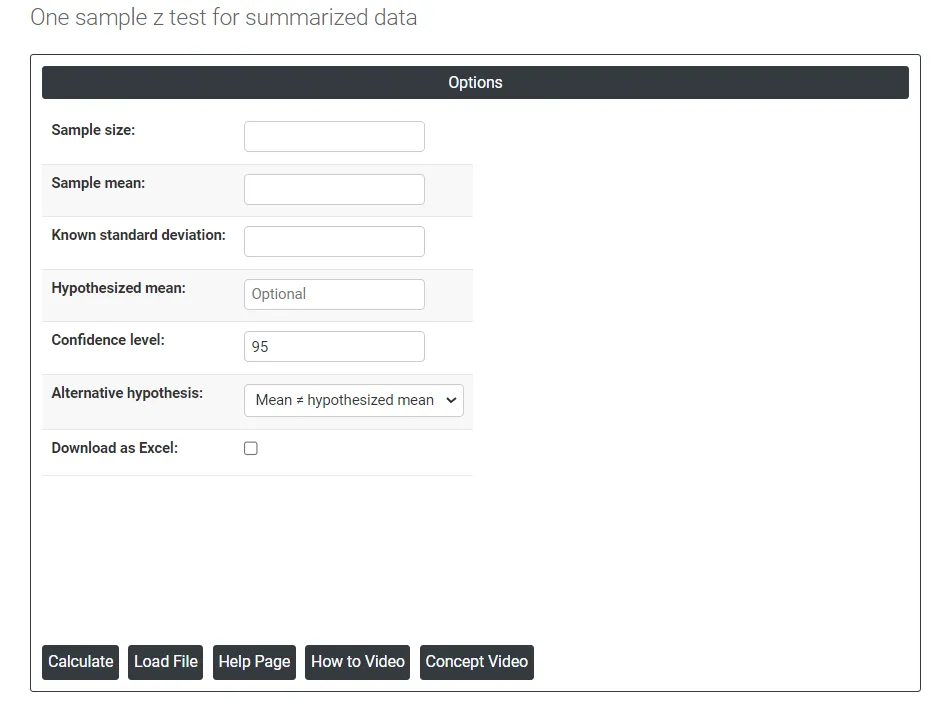
この部分には、次のような多くのオプションがあります。
- Sample size: サンプルサイズとは、母集団全体について結論を導くために、母集団から選んで調べる個人、物、事象の数を指します。言い換えると、調査に含まれる観測値または参加者の数です。サンプルの大きさは、調査結果の精度と信頼性に大きな影響を与えることがあります。一般に、サンプルサイズが大きいほど母集団をより代表する姿が得られ、ランダムな標本抽出誤差の影響を減らせます。したがって、結果が統計的に妥当で信頼できるものとなるよう、調査を行う前に適切なサンプルサイズを決定することが重要です。
- Sample mean: 標本平均は、より大きな母集団から選ばれた一連の観測値またはデータ点の平均値です。標本内のすべての値を合計し、観測数で割って計算します。標本平均は、母集団全体の平均値である母平均の推定量としてよく使用されます。
- Confidence level: 仮説検定において、信頼水準は、統計解析に対する確実性の度合い、つまり信頼の水準を表します。これは、真の母集団パラメータが指定した値の範囲内にある可能性を示す確率値です。通常、信頼水準は百分率で表され、(1 - α) と書かれます。ここでαは有意水準、すなわち真の帰無仮説を棄却する確率です。たとえば、信頼水準が95%であれば、真の母集団パラメータが区間推定の中にあると95%の確信があり、第1種の誤り(真の帰無仮説を棄却すること)を犯す確率が5%あることを意味します。実用上、信頼水準が高いほど、統計解析とその結果への確信が高いことを意味します。ただし、信頼水準を上げると信頼区間の幅も広がり、小さな効果を検出しにくくなります。したがって、信頼水準の選択は、調査の状況と研究者の目的によって決まります。
- Known standard deviation: 標本から推定したものではなく、過去の調査や履歴データからわかっている母集団の標準偏差(σ)です。検定統計量zは、標本平均と仮説の平均との差を、平均の標準誤差(σをサンプルサイズの平方根で割ったもの)で割って計算し、標準正規分布と比較します。
- Hypothesized mean: 仮説平均は、期待される平均や母平均とも呼ばれ、帰無仮説で指定される、検定する変数の平均値を表す値です。これは理論上の値であり、実際の標本平均と比較して、その差が統計的に有意なのか、偶然によるものなのかを判断するために使用されます。
- Alternative hypothesis: 仮説検定において、対立仮説(研究仮説とも呼ばれます)は、帰無仮説とは異なる結論を表す記述です。帰無仮説は通常、現状、つまり2つ以上のグループまたは変数の間に有意な差や関係がないという仮定を表します。対立仮説は検定の対象となる記述であり、調べているグループまたは変数の間に有意な差や関係があると主張します。
- Download as Excel:結果をExcel形式で表示します。Excel形式は簡単に編集でき、load fileオプションを使って再読み込みし、計算に使用できます。
よくある質問
1サンプルz検定とは何ですか?
1サンプルz検定は、母集団の標準偏差が既知の場合に、標本の平均が既知の母平均と有意に異なるかどうかを判定します。z統計量は、標本平均と仮説の平均との差を標準誤差(σをサンプルサイズの平方根で割ったもの)で割った値です。左片側検定、右片側検定、両側検定として実行できます。
1サンプルz検定の条件は何ですか?
母集団の標準偏差が既知であり、データ点が独立で、連続値で、ランダムに抽出されている必要があります。データは、特にサンプルサイズが20以下の場合、正規分布に従う必要があります。データが正規分布に従わない場合は、標本平均がほぼ正規分布になるよう、サンプルサイズが20より大きく、データが著しく歪んでいてはいけません。
1サンプルz検定とt検定の違いは何ですか?
z検定は、母集団の標準偏差が既知の場合に使用します。母集団の標準偏差が不明で、標本から推定する必要がある場合は、代わりに1サンプルt検定を使用します。計数データには1サンプルポアソン率検定を、合格/不合格のデータには1サンプルの比率検定を使用します。
Zometric Statistical Softwareで1サンプルz検定を実行するにはどうすればよいですか?
One sample z-testツールを開き、データを入力または貼り付けて、confidence level、known standard deviation、hypothesized mean、alternative hypothesisを設定し、Calculateをクリックします。要約データ版では、生データの代わりに、サンプルサイズ、標本平均、既知の標準偏差、仮説平均、信頼水準を入力します。