
1分散の検定(One Variance Test)
1分散の検定(具体的には1分散のカイ二乗検定)は、標本の分散を既知の母分散と比較するための統計的検定です。標本が正規分布に従う母集団から抽出されていることを仮定して、母分散に関する仮説を検定するために用います。
最終レビュー
重要なポイント
1分散の検定(具体的には1分散のカイ二乗検定)は、標本の分散を既知の母分散と比較するための統計的検定です。
1分散の検定とは
1分散の検定(具体的には1分散のカイ二乗検定)は、標本の分散を既知の母分散と比較するための統計的検定です。標本が正規分布に従う母集団から抽出されていることを仮定して、母分散に関する仮説を検定するために用います。帰無仮説(H₀)は母分散(σ²)が指定した値(σ₀²)に等しいとし、対立仮説(H₁)は分散がこの値と異なるとします。検定統計量は (n−1)*s^2/σ0^2 で計算されます。ここで s^2 は標本分散、σ0^2 は仮説の母分散、n はサンプルサイズです。この統計量は自由度 n−1 のカイ二乗分布に従うため、観測された分散が仮説の分散から有意にずれているかどうかを評価できます。この検定は通常、品質管理、リスク管理、実験研究において、観測されたばらつきが理論上の期待値や基準を満たしているかを評価するために使用されます。
1分散の検定を使用する場面
- 分散の評価:1つの標本の分散が既知の母分散と有意に異なるかを判断する必要がある場合。
- カイ二乗検定:具体的には、標本が正規分布に従う母集団から抽出されているという仮定に基づいて、標本の分散を指定した母分散と比較する1分散のカイ二乗検定を使用する場合。
- 正規分布:データが正規分布に従うと仮定される場合。この検定は、正確な結果を得るためにこの仮定に依存しています。
- 品質管理:生産工程や製品のばらつきが、期待される基準や規格に合致しているかを評価する場合。
- リスク管理:金融収益、業務指標、その他の指標のばらつきが、あらかじめ定めたリスク水準や閾値に沿っているかを評価する場合。
- 実験研究:実験データで観測されたばらつきが、理論上の予測や期待値に適合しているかを検定する場合。
- 一貫性の検定:測定値や工程の出力の一貫性を、既知の基準やベンチマークに対して評価する場合。
1分散の検定を正しく使用するためのガイドライン
- ランダムサンプリング:母集団について妥当な一般化を行えるよう、標本データをランダムに選択します。
- データの分布:標本データは大きく歪んでいてはいけません。Bonett法では、軽度に歪んだデータであっても、40を超えるサンプルサイズが推奨されます。サンプルが小さい場合は、歪度や異常な観測値を確認し、裾の重い分布のデータには注意して使用してください。[注:カイ二乗法は、データが正規分布に従う場合にのみ使用してください。逸脱は結果に大きく影響しうるためです。]
- 観測値の独立性:各観測値は他のすべての観測値から独立している必要があります。従属した観測値は結果を無効にする可能性があります。
- 適切なサンプルサイズ:精度の高い推定、狭い信頼区間、第1種および第2種の過誤に対する十分な保護を得られるよう、サンプルサイズを十分に大きくします。
代替手法:1分散の検定を使用すべきでない場合
- サンプルサイズが小さい場合:1分散の検定には、検出力を確保するための最小限のサンプルサイズが必要です。サンプルサイズが小さいと検定は信頼できない可能性があり、t検定 などの代替検定の方が適切な場合があります。
1分散の検定の例
製材所の管理者が、長さ100 cmとなるはずの梁を切断する製材機の効率を評価しています。そのために、管理者は製材機から50本の梁を抽出して長さを測定します。続いて、1分散の検定を行い、製材機の標準偏差が1と有意に異なるかを判断します。手順は次のとおりです。
- 必要なデータを収集しました。
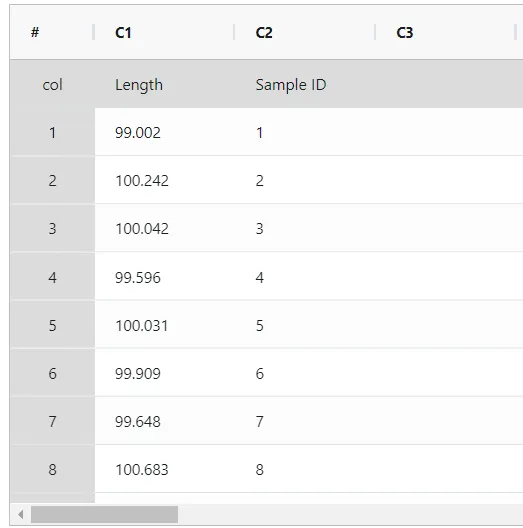
- 次に、Zometric Statistical Software(https://statsai.zometric.com/)でデータを分析します。
- One variance test を見つけるには、Statistical module> Graphical analysis> One variance test を選択します。
- ツール内で、次のように他の入力とともにデータを入力します。
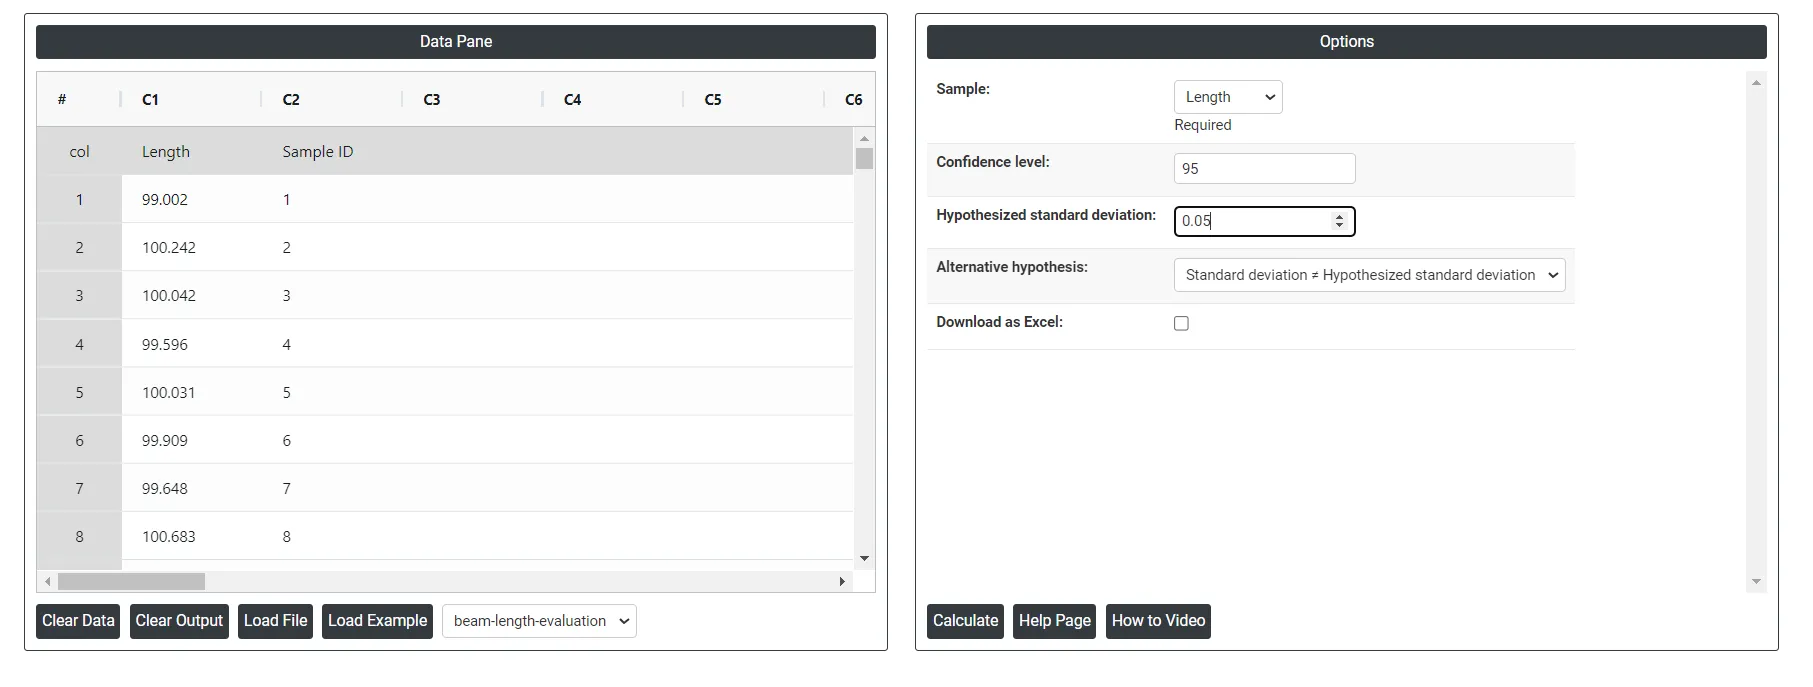
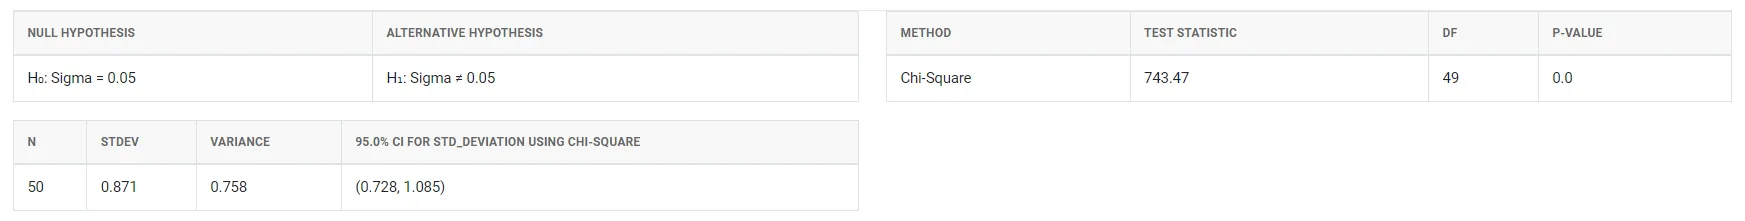
5. 上記のツールを使用すると、次のような出力が得られます。
1分散の検定の実行方法
手順は次のとおりです。
- まず、Zometric Statistical Softwareにログインします:https://statsai.zometric.com/
- ホームページで Statistical Tool> Graphical analysis >One variance test を選択します。
- 次に One variance test をクリックしてダッシュボードを開きます。
- 次に、データを手動で入力するか、Excelシートからデータ全体をコピー(Ctrl+C)してここに貼り付けます(Ctrl+V)。
- 次に、信頼水準と仮説の標準偏差の値を入力します。
- 最後に、ページ下部のcalculateをクリックすると、目的の結果が得られます。
One variance test のダッシュボードでは、ウィンドウが2つの部分に分かれています。
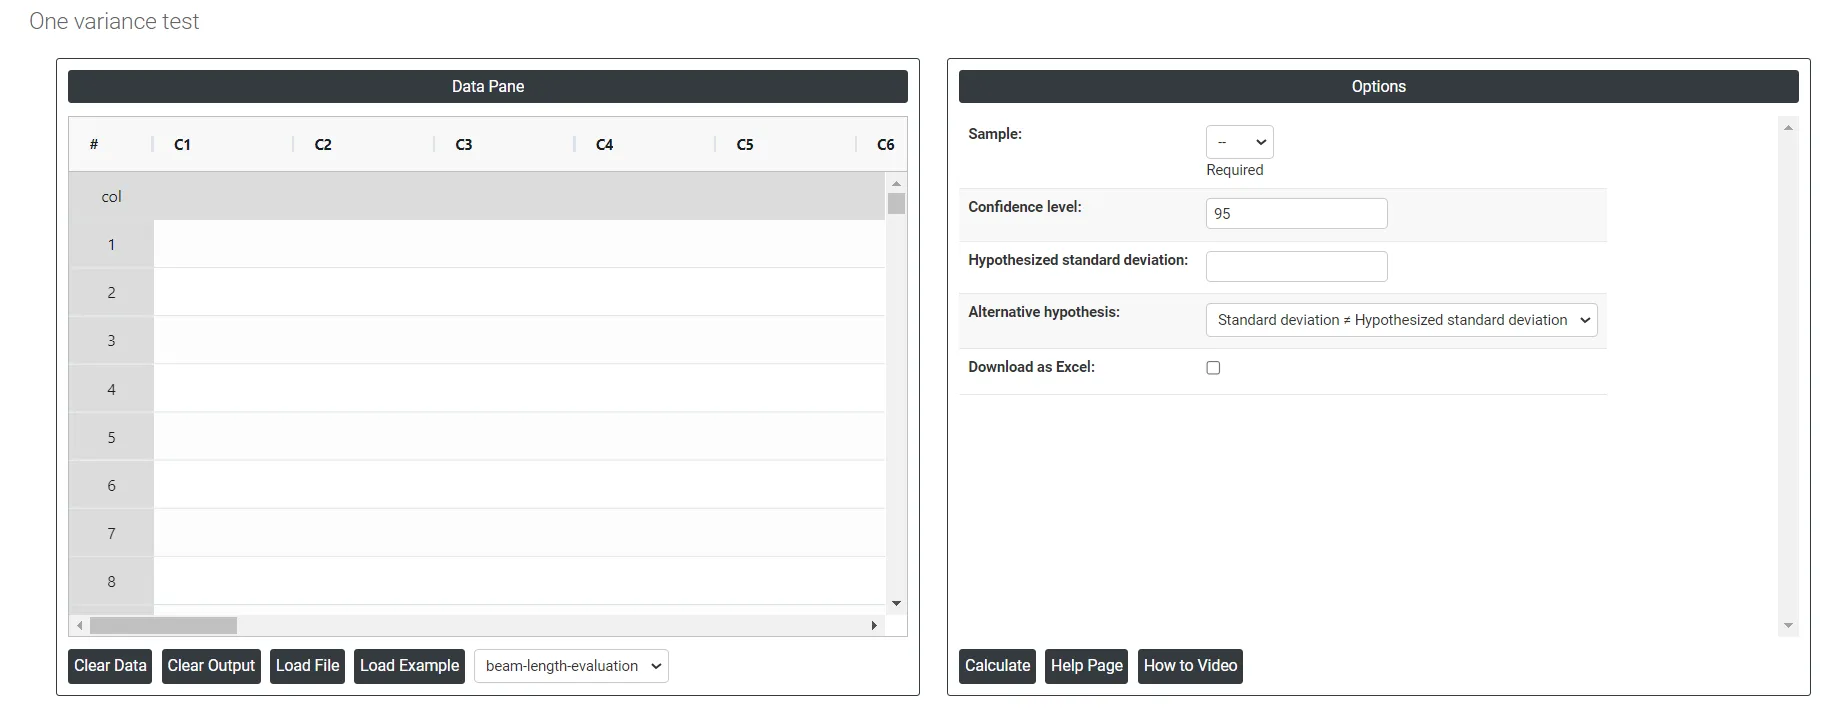
左側にはデータペイン(Data Pane)があります。Data Paneでは、各行が1つのサブグループになります。データは手動で入力するか、Excelシートからデータ全体をコピー(Ctrl+C)してここに貼り付ける(Ctrl+V)ことができます。
Load example: サンプルデータが読み込まれます。
Load File: Excelデータを直接読み込むために使用します。
右側には、次のような多くのオプションがあります。
- Confidence level: 仮説検定における信頼水準は、統計分析に対して持つ確実性の度合い、すなわち信頼の水準を表します。真の母集団パラメータが指定した範囲の値に含まれる可能性を示す確率値です。通常、信頼水準はパーセントで表され、(1 - α) で示されます。α は有意水準、すなわち真の帰無仮説を棄却する確率です。たとえば、信頼水準が95%であれば、真の母集団パラメータが区間推定値に含まれると95%確信しており、第1種の過誤(真の帰無仮説を棄却すること)を犯す可能性が5%あることを意味します。実際には、信頼水準が高いほど、統計分析とその結果への確信が強いことを意味します。ただし、信頼水準を上げると信頼区間の幅も広がり、小さな効果を検出しにくくなります。したがって、信頼水準の選択は、研究の文脈と研究者の目標によって決まります。
- Hypothesized standard deviation: 仮説の標準偏差は、想定標準偏差または既知の標準偏差とも呼ばれ、仮説検定の目的で真であると仮定される母標準偏差の値です。
- Alternative hypothesis: 仮説検定における対立仮説(研究仮説とも呼ばれます)は、帰無仮説とは異なる結論を表す記述です。帰無仮説は通常、現状、または2つ以上のグループや変数の間に有意な差や関係がないという仮定を表します。対立仮説は検定される記述であり、調べているグループや変数の間に有意な差や関係があることを主張します。
- Download as Excel:結果をExcel形式で表示します。Excel形式は容易に編集でき、load fileオプションで再読み込みして計算に使用できます。
よくある質問
1分散の検定とは何ですか?
1分散の検定(具体的には1分散のカイ二乗検定)は、標本の分散を、既知または仮説の母分散と比較します。帰無仮説は母分散が指定した値に等しいとし、対立仮説はそれと異なるとします。品質管理、リスク管理、実験研究で使用されます。
1分散のカイ二乗統計量はどのように計算されますか?
検定統計量は、(n - 1) に標本分散 s² を掛け、仮説の母分散 σ0² で割った値です。ここで n はサンプルサイズです。この統計量は自由度 n - 1 のカイ二乗分布に従い、観測された分散が仮説の分散から有意にずれているかどうかを評価するために使用します。
1分散の検定の前提条件は何ですか?
標本はランダムに選択し、観測値は独立している必要があります。カイ二乗法は、データが正規分布に従う場合にのみ使用してください。逸脱は結果に大きく影響しうるためです。Bonett法では、軽度に歪んだデータであっても、40を超えるサンプルサイズが推奨されます。サンプルが小さい場合は、歪度、異常な観測値、裾の重さを確認してください。
1分散の検定はどのような場合に使用しますか?
1つの標本のばらつきが既知の基準と異なるかを知る必要がある場合に使用します。たとえば、生産工程や測定システムが、規格やベンチマークの求める一貫性を満たしているかを確認する場合です。精度の高い推定、狭い信頼区間、第1種および第2種の過誤に対する保護を得るため、標本は十分に大きい必要があります。