
工程能力(正規分布)
正規分布の工程能力は、工程のばらつきと中心の位置を、LSLおよびUSLと比較します。安定した工程から得た、連続で正規分布に従うデータに使用し、理想的には合理的なサブグループで100個以上のデータが必要です。CpとCpkはサブグループ内標準偏差、PpとPpkは全体の長期標準偏差を使用します。工程能力のある工程の最小値として、CpkまたはPpkが1.33以上であることが一般に認められています。
最終レビュー
重要なポイント
正規データの工程能力分析は、安定した工程が規格限界内の出力を、どれだけ一貫して生み出しているかを、CpとCpk(サブグループ内)、PpとPpk(全体、長期)の指数で測定します。
このページの内容
工程能力(正規分布の場合)とは
工程能力は、製造工程があらかじめ定められた規格や公差を満たす部品を生産する能力を表す統計的な尺度です。寸法や重量などの工程特性に固有のばらつきを定量化し、工程が規格限界内でどれだけ一貫して生産できるかを判断します。要するに、工程能力は、工程の自然なばらつきを評価して、工程が安定しており、設計基準に一貫して適合する製品を生産できるかどうかを判断します。工程能力のある工程の最小値として、CpkまたはPpkが1.33以上であることが一般に認められています。この尺度は、製品品質の確保と、工程改善の機会の特定に不可欠です。
- 潜在工程能力(Cp):この指標は、工程が規格限界の中心にあると仮定して、工程のばらつきの幅を規格限界の幅と比較します。工程能力が最良の場合のシナリオを示します。
- 実際の工程能力(Cpk):この指標は、目標の規格からのずれを含め、工程の実際の性能を考慮します。工程の広がりと平均のシフトの両方を考慮に入れるため、工程が生産中に規格をどれだけ満たしているかについて、現実的な尺度を提供します。
- シグマ(σ):計数値データでよく使用されるシグマは、欠点率で表した工程能力の推定値です。工程平均から最も近い規格限界までの標準偏差の数を示します。シグマの値が高いほど、欠点率が低く、工程能力が高いことを意味します。
- 工程性能指数(PpとPpk):CpおよびCpkと似ていますが、全体(長期)の標準偏差で計算されるため、調査した期間全体にわたる工程の実際の性能を測定します。Ppは規格の幅に対する全体のばらつきを評価し、Ppkは評価した期間中の平均のシフトも考慮します。
工程能力を使用する場面
工程能力分析が一般的に用いられる場面は、次のとおりです。
- 品質管理:工程能力分析は、製造業で、生産工程が顧客の要求を満たす能力を評価するために広く使用されています。工程が、規定された公差内の製品を生産できるかどうかを特定するのに役立ちます。
- 工程改善:工程能力分析は、工程の改善すべき領域を特定するために使用できます。工程の現在の能力を理解することで、組織は、ばらつきを減らし、工程が顧客のニーズを満たす能力を高めるための改善を的を絞って行えます。
- 新製品開発:新しい製品や工程を導入する際、工程能力分析は、工程の性能についての知見を与え、必要な規格を満たしているかどうかを判断するのに役立ちます。組織は、潜在的な問題を早期に特定し、本格的な生産の前に必要な調整を行えます。
- サプライヤーの評価:工程能力分析は、サプライヤーが規定の要求事項を満たす能力を評価するために利用できます。サプライヤーの工程能力を評価することで、組織は、サプライヤーを選定または評価する際に、十分な情報に基づいた判断を下せます。
- シックスシグマのプロジェクト:工程能力分析は、シックスシグマの方法論に不可欠な要素です。初期の工程能力を測定し、基準となる性能を確立し、工程改善の取り組みの有効性を評価するのに役立ちます。
工程能力(正規分布)を正しく使用するためのガイドライン
- 連続データを使用する:連続データは、小数や分数を含め、ある範囲内の任意の数値をとることができます。
- 計数値データには適切な分析を使用する:欠点の個数には、二項分布の工程能力分析またはポアソン分布の工程能力分析を使用します。
- 十分なデータを収集する:少なくとも100個のデータを収集することを目標にします。例えば、大きさ4の25個のサブグループ、または大きさ3の35個のサブグループです。
- 合理的なサブグループでデータを収集する:サブグループは、一貫した条件のもとで短時間に生産された、類似した品目の小さなサンプルにします。
- 工程の安定性を確保する:工程は安定していて管理状態にある必要があります。安定性の評価には、Xbar-S管理図または工程能力シックスパック(正規)を使用します。
- データの正規性を確保する:データは正規分布に従う必要があります。従わない場合は、Box-CoxまたはJohnson変換を使用するか、非正規工程能力の分析を検討します。
代替手法:工程能力(正規分布)を使用すべきでない場合
- 工程データが管理状態にあるかどうか、または正規分布を使って評価できるかどうかがわからない場合は、この分析を使用する前に、工程能力シックスパック(正規)でこれらの仮定を評価します。
- データが非正規で、データを変換するのではなく、非正規分布を当てはめて工程能力を評価したい場合は、非正規工程能力の分析を使用します。
- 不良品の個数や欠点の個数などの計数値データがある場合は、二項分布の工程能力分析またはポアソン分布の工程能力分析を使用します。
工程能力(正規分布)の例
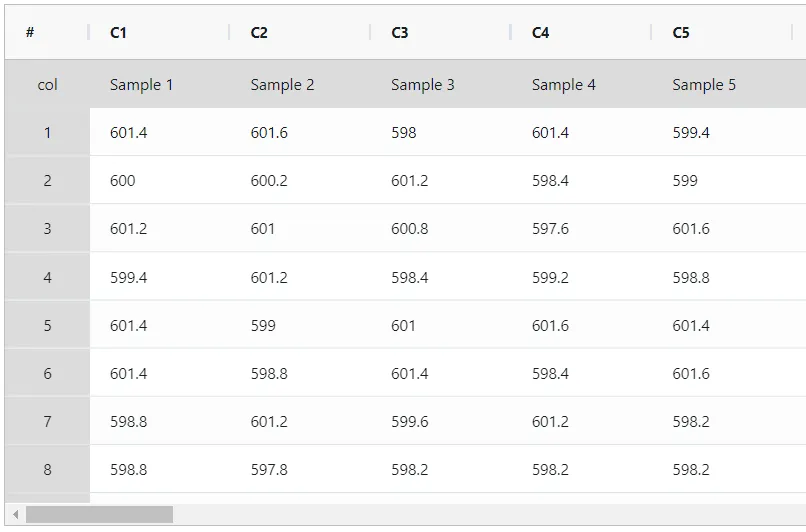
自動車部品工場の品質エンジニアが、カムシャフトの長さを監視しています。エンジニアは、1台の機械から30分ごとに、サブグループサイズ5でデータを収集します。カムシャフトの長さの規格限界は、下限規格値(LSL)595 mm、目標値600 mm、上限規格値(USL)605 mmに設定されています。エンジニアは、カムシャフトの長さを規格限界と比較して評価するために、正規分布の工程能力分析を使用します。手順は次のとおりです。
- 必要なデータを収集しました。
- 次に、Zometric Statistical Software(https://statsai.zometric.com/)でデータを分析します。
- 工程能力は、Statistical module> Graphical analysis>Process Capabilityから選択します。
- ツール内で、データとその他の入力を次のように入力します。
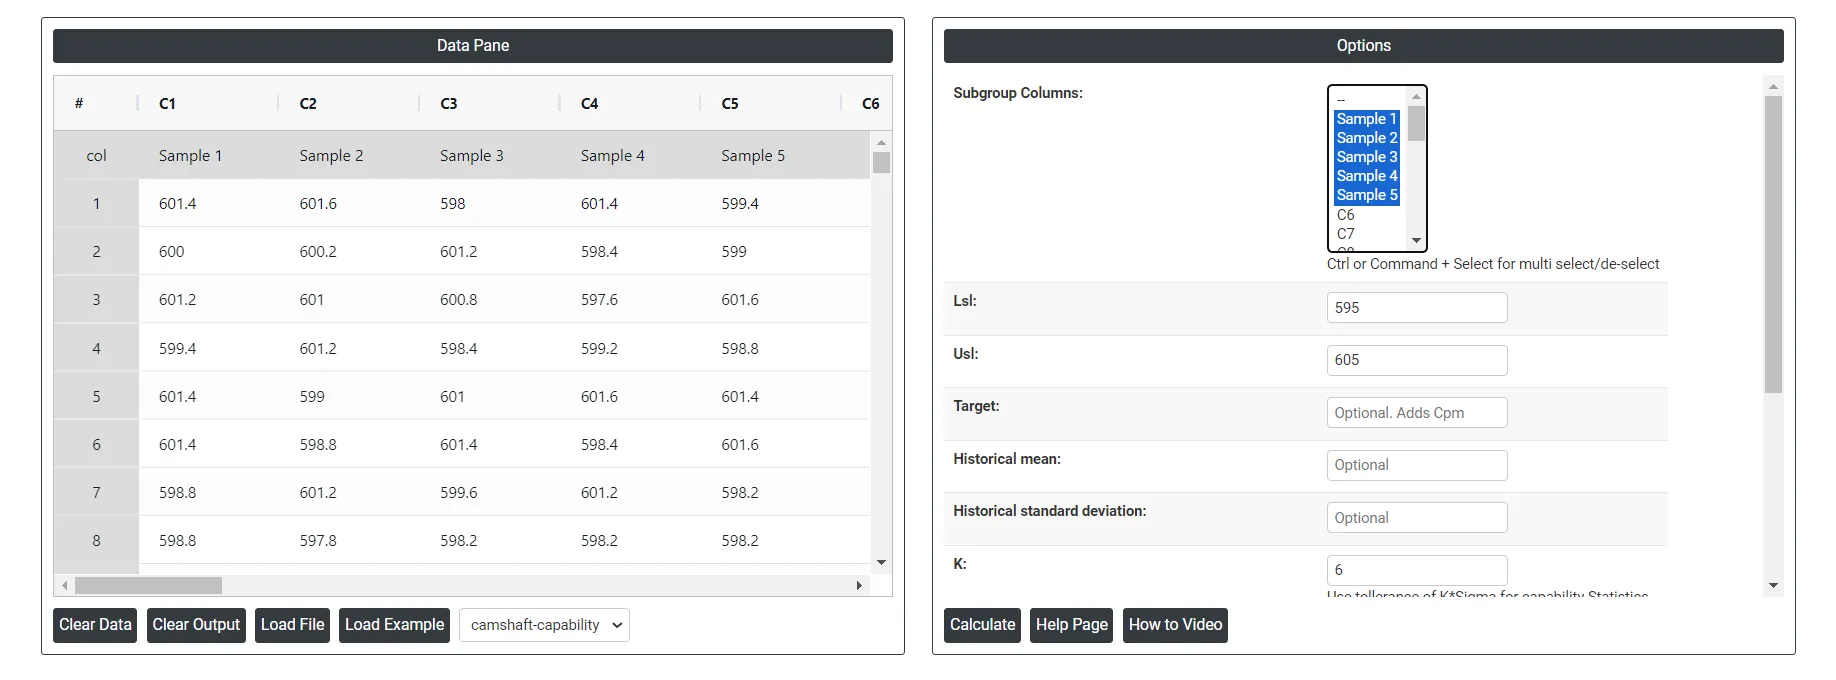
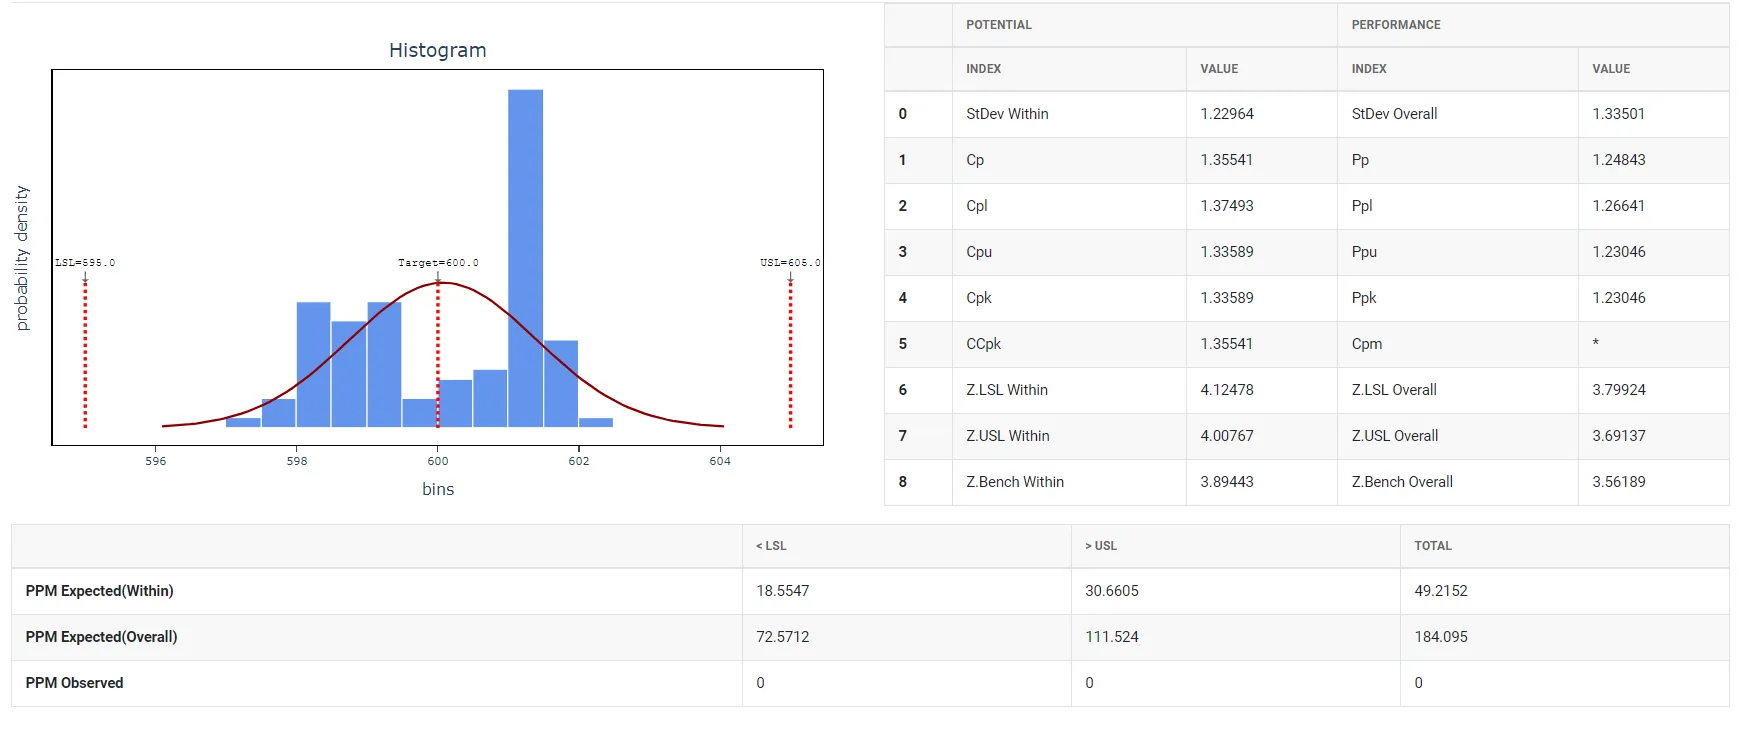
5. 上記のツールを使用すると、次のような出力が得られます。
工程能力の実行方法
手順は次のとおりです。
- まず、Zometric Statistical Software にログインします:https://statsai.zometric.com/
- ホーム画面でStatistical Tool> Graphical analysis >Process Capabilityを選択します。
- 次に Process Capability をクリックしてダッシュボードを開きます。
- 次に、データを手動で入力するか、Excelシートからデータ全体をコピー(Ctrl+C)してここに貼り付けます(Ctrl+V)。
- 次に、lsl、usl、target、Kなどの必要な項目を入力します。
- 最後に、ページ下部のcalculateをクリックすると、目的の結果が得られます。
Process Capabilityのダッシュボードでは、画面が2つの部分に分かれています。
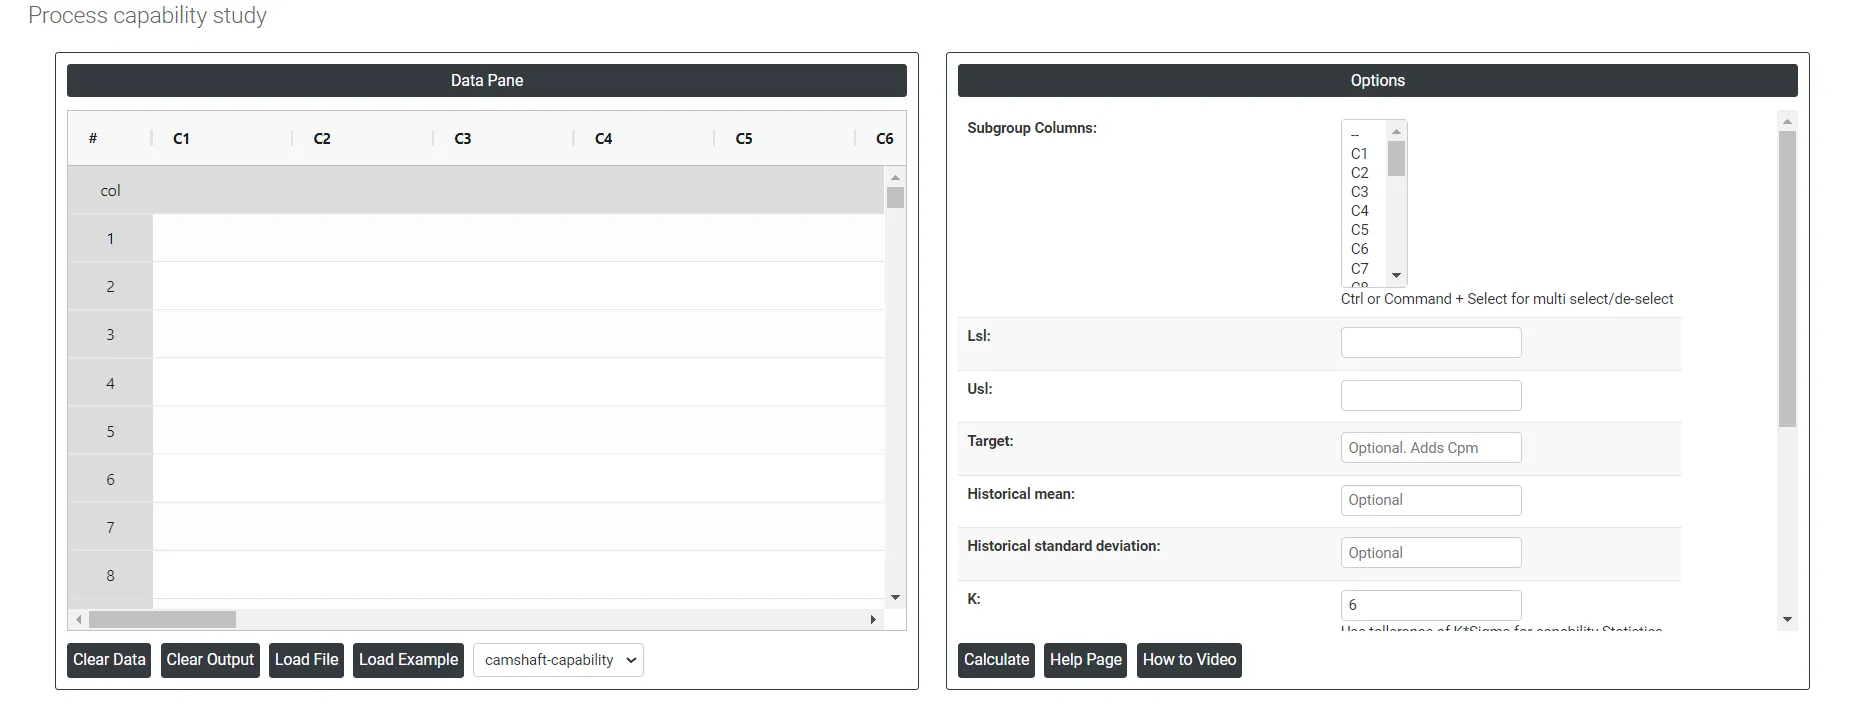
左側にはデータペイン(Data Pane)があります。Data Paneでは、各行が1つのサブグループになります。データは手動で入力するか、Excelシートからデータ全体をコピー(Ctrl+C)してここに貼り付ける(Ctrl+V)ことができます。
Load example: サンプルデータが読み込まれます。
Load File: Excelのデータを直接読み込むために使用します。
右側には、次のような多くのオプションがあります。
- Lsl: 工程能力におけるLSLは下限規格値(Lower Specification Limit)を指します。特定の工程パラメーターや特性に対して設定された下側の境界、つまりしきい値です。工程能力分析では、LSLを用いて、工程が目標とする範囲や規格内の出力を生産する能力があるかどうかを判断します。
- Usl: 工程能力におけるUSLは上限規格値(Upper Specification Limit)を指します。特定の工程パラメーターや特性に対して設定された上側の境界、つまりしきい値を表します。工程能力分析では、USLを用いて、工程が目標とする範囲や規格内の出力を生産する能力があるかどうかを評価します。
- Target: 工程能力における目標値(target)は、特定の工程パラメーターや特性に対する望ましい、または理想的な値を指します。工程が達成する、またはその周りに中心を置くことを意図した値を表します。目標値は、設計の規格や顧客の要求に基づくことが多くあります。
- Historical Mean: 工程能力における過去の平均は、過去のデータに基づく、工程パラメーターや特性の平均、つまり中心傾向を指します。工程が一定期間にわたって示した、典型的な、または期待される値を表します。
- Historical Standard Deviation: 工程能力における過去の標準偏差は、過去のデータに基づく、工程パラメーターや特性の散らばりやばらつきの尺度を指します。データ点が過去の平均、つまり中心傾向からどれだけ離れているかを定量化します。
- K: 工程能力統計量の公差乗数です。工程の広がりはK × sigmaとして扱われます。既定値は6で、標準的な6シグマの慣例です。
- Within Stdev estimation method:
- Pooled: 併合標準偏差は、サブグループの分散の加重平均で、大きいサブグループほど全体の推定値に与える影響が大きくなります。この方法は、工程が安定しているときに、より正確な標準偏差の推定値を与えます。
- Rbar: Rbarは、サブグループ内の範囲の平均を表します。Rbar法は広く使用されている標準偏差の推定値で、サブグループサイズが2〜8の場合に特に有効です。
- Sbar:サブグループの標準偏差の平均(Sbar)を計算して、工程のばらつきを監視します。SbarはS管理図の管理限界の設定に不可欠で、データの散らばりの経時的な変化を示します。この方法により、品質管理の実務において、工程のばらつきを一貫して正確に評価できます。
- Within stdev estimation method for subgroup size = 1:
- Average Moving Range: 平均移動範囲は、2つ以上の連続する点の範囲の平均値で、通常、サブグループサイズが1のときに使用されます。
- Median Moving Range: 移動範囲の中央値は、2つ以上の連続する点の範囲の中央の値で、移動範囲を歪める可能性のある極端な範囲がデータにある場合に推奨されます。
- Square root of MSSD: MSSD(Mean of Squared Successive Differences、連続する差の2乗の平均)の平方根は、連続する点の間の差の2乗の平均の平方根で、連続する点が似た条件のもとで収集されていない場合に有用です。
- Moving range of length: 移動範囲の計算に使用する観測値の数を指定します。長さは100以下です。連続する値は互いに似ている可能性が最も高いため、既定の長さは2です。
- Use Unbiasing Constants: サブグループ内標準偏差の推定に不偏化定数を適用します。Sbar、併合標準偏差、MSSDの平方根の各方法に関係します。
- Use Unbiasing Constants to Calculate Overall Standard Deviation: 全体の標準偏差の推定に不偏化定数を適用します。
- Download as Excel: 結果をExcel形式で表示します。Excel形式のデータは容易に編集でき、load fileオプションで再読み込みして計算に使用できます。
よくある質問
工程能力分析とは何ですか?
工程能力は、工程があらかじめ定められた規格や公差を満たす部品を生産する能力を表す統計的な尺度です。寸法や重量などの特性のばらつきを定量化し、工程が規格限界内でどれだけ一貫して生産しているかを判断します。工程能力のある工程の最小値として、CpkまたはPpkが1.33以上であることが一般に認められています。
Cp、Cpk、Pp、Ppkの違いは何ですか?
Cpは、工程が中心にあると仮定して、工程のばらつきの幅を規格限界の幅と比較し、潜在的な工程能力を最良の場合として示します。Cpkは、平均のずれも考慮します。PpとPpkも似ていますが、全体の長期標準偏差を使用するため、調査した期間全体にわたる実際の性能を測定します。Ppkも平均のシフトを考慮します。
工程能力調査には、どのくらいのデータが必要ですか?
少なくとも100個のデータを目標にします。例えば、大きさ4の25個のサブグループ、または大きさ3の35個のサブグループです。データは合理的なサブグループ、すなわち、一貫した条件のもとで短時間に生産された類似した品目の小さなサンプルで収集します。データは連続で、工程は安定していて管理状態にある必要があり、Xbar-S管理図または工程能力シックスパック(正規)で確認します。
データが非正規の場合や、計数値データの場合はどうすればよいですか?
データが非正規の場合は、Box-CoxまたはJohnson変換を使用するか、非正規工程能力の分析で非正規分布を当てはめます。不良品の個数や欠点の個数などの計数値データには、二項分布の工程能力分析またはポアソン分布の工程能力分析を使用します。安定性や正規性が不明な場合は、まず工程能力シックスパック(正規)で両方を確認してください。