
Carte Xbar-R
Les cartes X Bar R sont des outils essentiels pour surveiller la stabilité des procédés mettant en jeu des données variables, dans de nombreux secteurs industriels. Ces cartes sont particulièrement utiles pour examiner des données continues afin d'évaluer la performance d'un procédé.
Dernière révision
Point clé
Les cartes X Bar R sont des outils essentiels pour surveiller la stabilité des procédés mettant en jeu des données variables, dans de nombreux secteurs industriels.
Sur cette page
Qu'est-ce qu'une carte Xbar-R ?
Les cartes X Bar R sont des outils essentiels pour surveiller la stabilité des procédés mettant en jeu des données variables, dans de nombreux secteurs industriels. Ces cartes sont particulièrement utiles pour examiner des données continues afin d'évaluer la performance d'un procédé. En recueillant des données par sous-groupes à intervalles fixes, les cartes X Bar R fournissent deux graphiques : l'un pour surveiller la moyenne du procédé (carte X Bar) et l'autre pour surveiller la variation du procédé (carte R) au fil du temps.
Les cartes X Bar R sont déterminantes pour repérer la variabilité à la fois de la moyenne et de l'étendue du procédé. Elles sont précieuses pour évaluer les effets des initiatives d'amélioration des procédés. La carte X Bar détecte les décalages de la moyenne du procédé, tandis que la carte R met en évidence les changements de variabilité du procédé. Ensemble, elles permettent un contrôle et une évaluation complets de la constance du procédé au fil du temps. Elles aident à repérer les tendances et motifs qui peuvent révéler des problèmes sous-jacents dans le procédé. En offrant une représentation visuelle claire du comportement du procédé, ces cartes soutiennent la prise de décision fondée sur les données et les efforts d'amélioration continue. Elles sont particulièrement utiles dans les environnements où le maintien d'un contrôle serré des paramètres du procédé est essentiel pour garantir la qualité du produit et l'efficacité opérationnelle.
Quand utiliser une carte Xbar-R ?
La carte Xbar-R s'utilise lorsque la taille de sous-groupe est supérieure à un et que l'effectif de l'échantillon est petit ou moyen (moins de 10). Elle sert à surveiller la tendance centrale (moyenne) et la variabilité (étendue) d'un procédé au fil du temps lorsque la normalité peut être supposée. La carte Xbar-R aide à détecter les changements de la moyenne et de la variabilité du procédé, qui peuvent indiquer un besoin d'amélioration du procédé. Elle est couramment utilisée dans l'industrie manufacturière et d'autres secteurs où la maîtrise de la qualité est importante.
Recommandations pour bien utiliser la carte Xbar-R
- Utilisez des données continues pour les cartes de contrôle aux variables, et des données d'attribut pour la carte P ou la carte U.
- Saisissez les données dans l'ordre chronologique, les plus anciennes en haut.
- Recueillez les données à intervalles de temps réguliers.
- Utilisez des sous-groupes rationnels, c'est-à-dire de petits échantillons d'unités similaires produites dans les mêmes conditions.
- La taille de sous-groupe doit être de 8 ou moins ; au-delà, utilisez la carte Xbar-S, et la carte I-MR en l'absence de sous-groupes.
- Recueillez une quantité de données appropriée selon la taille de sous-groupe.
- Les cartes de contrôle peuvent encore fonctionner avec des données non normales si elles sont recueillies en sous-groupes.
- Évitez les points de données corrélés au sein des sous-groupes, pour que les limites de contrôle ne soient pas trop étroites.
Alternatives : quand ne pas utiliser la carte Xbar-R
- Pour des sous-groupes de 9 observations ou plus, optez pour la carte Xbar-S, sauf s'il existe une source constante de variation au sein des sous-groupes ; dans ce cas, utilisez la carte I-MR-R/S.
- Si vous n'avez pas de sous-groupes, utilisez la carte I-MR.
- Si vos données portent sur des comptages d'unités défectueuses ou de défauts, employez une carte de contrôle aux attributs comme la carte P ou la carte U.
Exemple de carte Xbar-R
Voyons comment réaliser une carte Xbar et une carte R à l'aide d'un exemple. Supposons qu'un ingénieur veuille surveiller un procédé de fabrication d'arbres à cames pour son client constructeur automobile. 5 échantillons ont été recueillis dans chaque sous-groupe. Un sous-groupe se compose d'échantillons recueillis sur une courte période, typiquement des pièces consécutives produites par une même machine. Les données des sous-groupes ont été recueillies environ toutes les 30 minutes. Les données suivantes ont été recueillies :
- Rassembler les données nécessaires.
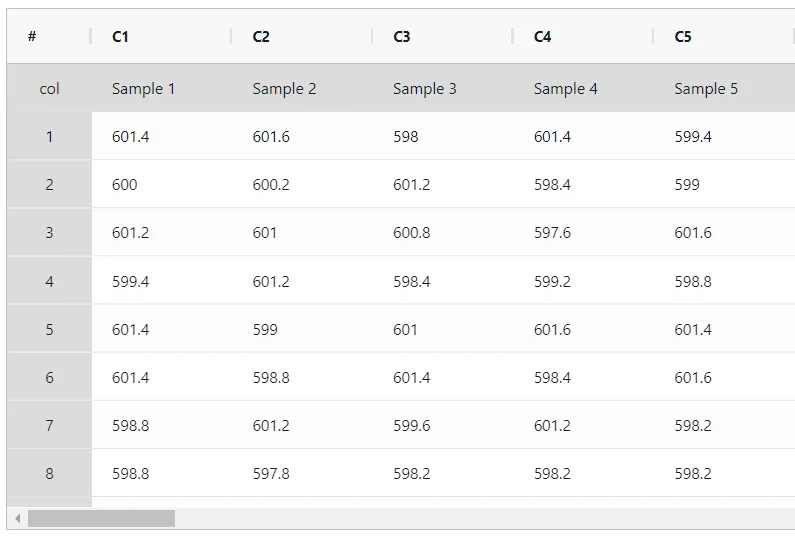
2. Analysez maintenant les données dans Zometric Statistical Software à l'adresse https://statsai.zometric.com/.
3. Pour trouver X Bar R Chart, choisissez Statistical module> Control Charts> X Bar R Chart.
4. Dans l'outil, saisissez les données ainsi que les autres paramètres comme suit :
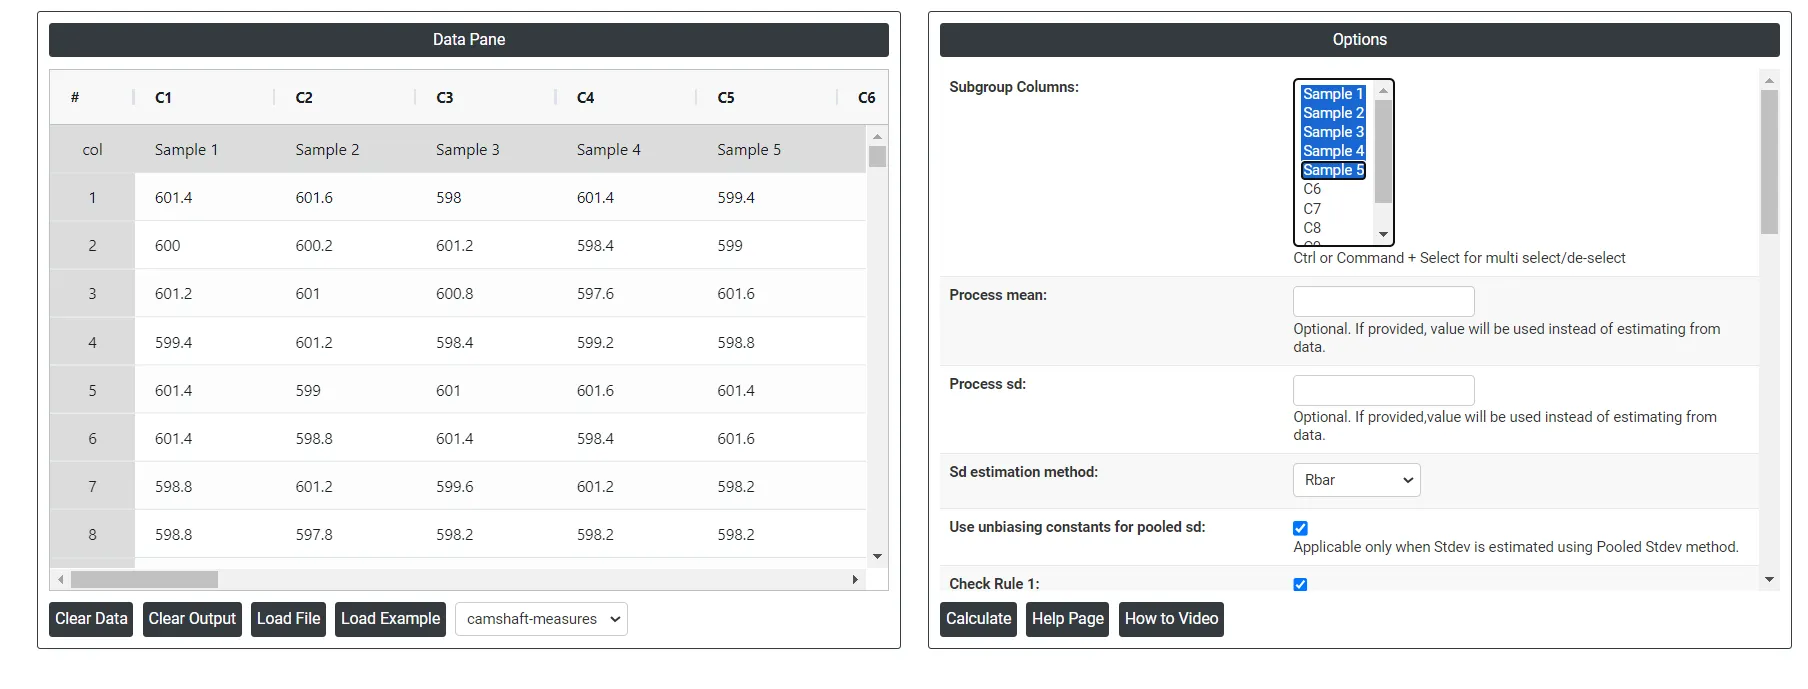
5. Après exécution de l'outil, les résultats obtenus sont les suivants :
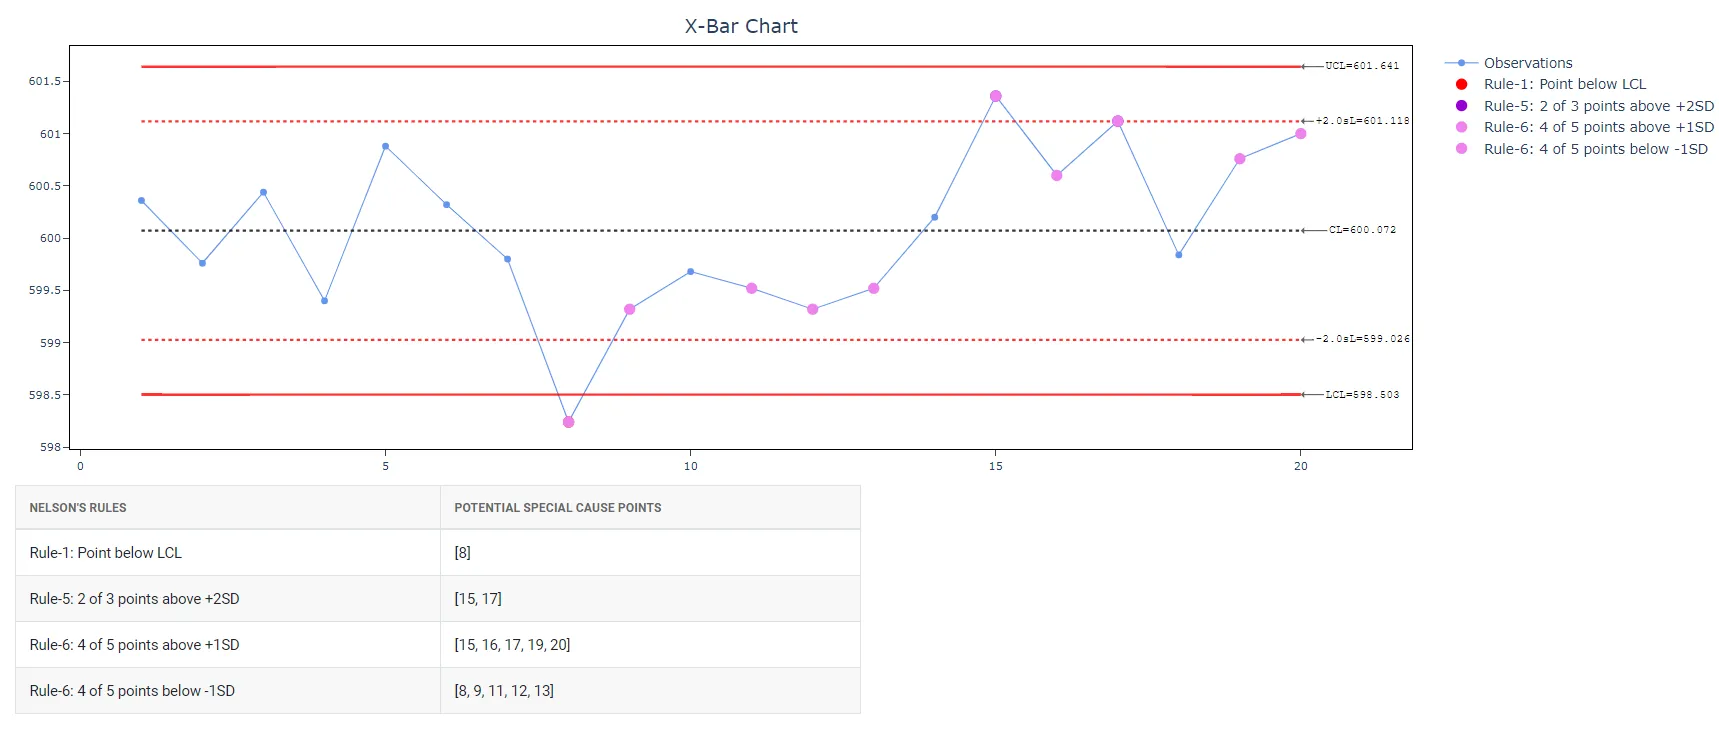
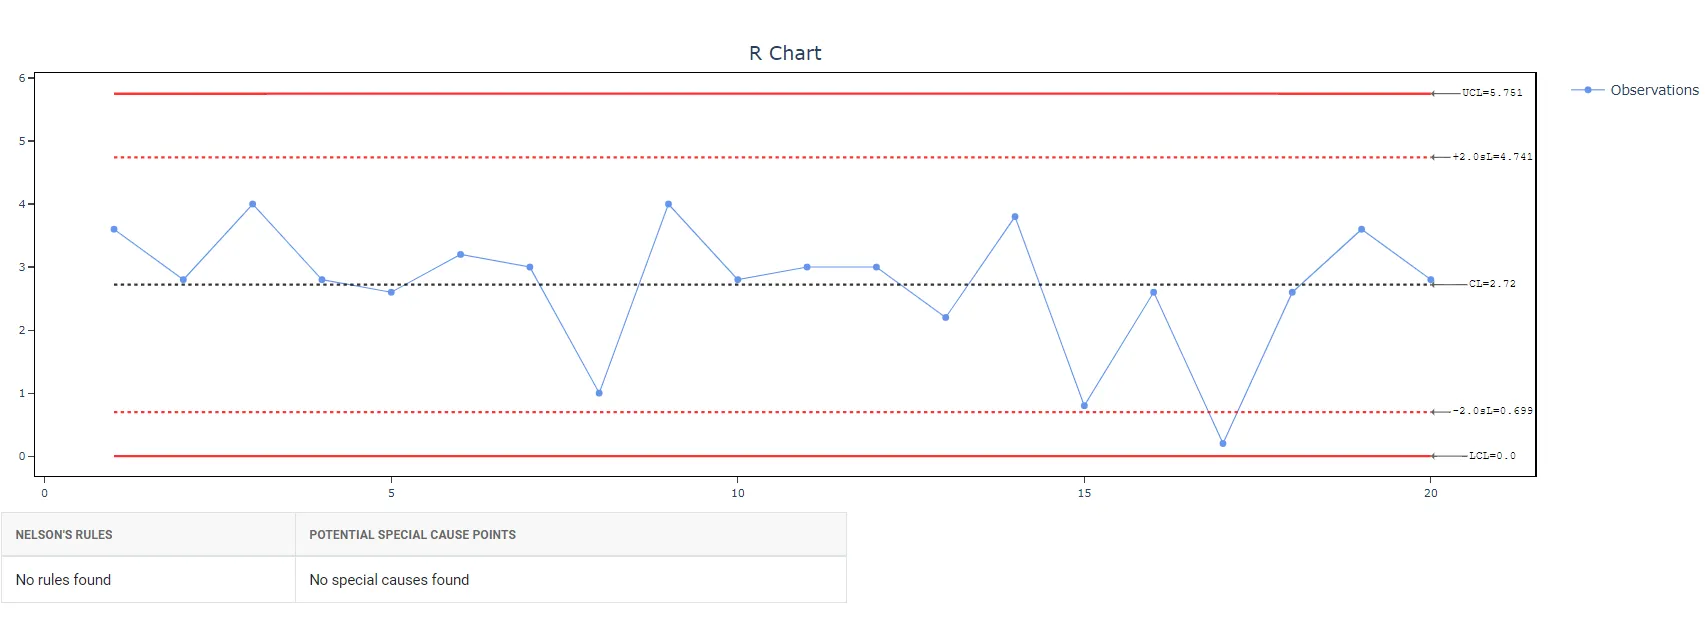
Comment réaliser une carte Xbar-R
La marche à suivre est la suivante :
- Connectez-vous à votre Zometric Statistical Software à l'adresse https://statsai.zometric.com/
- Sur la page d'accueil, choisissez Statistical Tool> Control Charts >Xbar R Chart.
- Cliquez sur Xbar-R Chart pour accéder au tableau de bord.
- Ensuite, saisissez les données manuellement ou copiez-les (Ctrl+C) depuis une feuille Excel et collez-les (Ctrl+V) ici.
- Ensuite, choisissez la Sd estimation method ainsi que les Check Rules souhaitées.
- Enfin, cliquez sur calculate en bas de la page pour obtenir les résultats.
Sur le tableau de bord de Xbar-R chart, la fenêtre est divisée en deux parties.
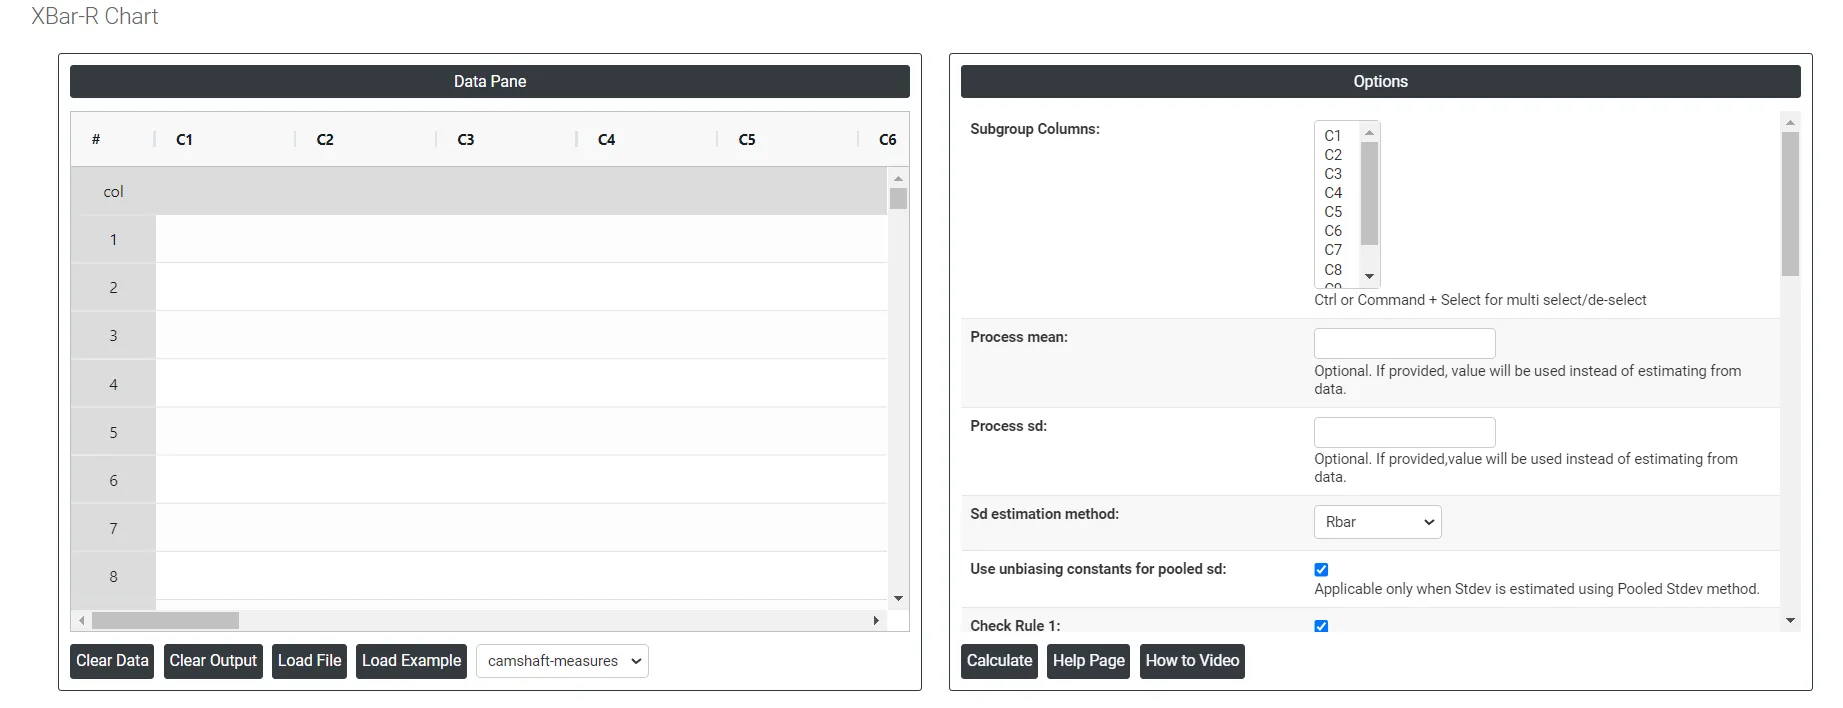
Dans la partie gauche se trouve le Data Pane (volet de données). Dans le Data Pane, chaque ligne constitue un sous-groupe. Les données peuvent être saisies manuellement, ou copiées (Ctrl+C) depuis une feuille Excel et collées (Ctrl+V) ici.
Load example : des données d'exemple sont chargées.
Load File : permet de charger directement des données Excel.
Dans la partie droite se trouvent de nombreuses options, comme suit :
- Process mean : la valeur moyenne d'un ensemble de mesures ou d'observations d'un procédé. Elle représente la tendance centrale des données du procédé au fil du temps et constitue un indicateur clé de la performance du procédé. Sinon, Zometric Statistical Software calcule la ligne centrale à partir des données fournies.
- Process sd : une mesure de la variabilité ou de la dispersion des données du procédé autour de la moyenne. Elle indique dans quelle mesure les points de données individuels du procédé s'écartent de la moyenne du procédé. Si vous la laissez vide, Zometric Statistical Software la calcule à partir des données fournies.
- Sd estimation method : laisse à l'utilisateur deux choix de calcul. Choisir Rbar comme méthode d'estimation ou la méthode de l'écart-type groupé modifie le résultat.
- Rbar Sd estimation method : Rbar représente la moyenne des étendues intra-sous-groupe. La méthode Rbar est une estimation de l'écart-type très utilisée, particulièrement efficace pour des tailles de sous-groupe de 2 à 8.
- Pooled Sd estimation method : l'écart-type groupé est la moyenne pondérée des variances des sous-groupes, les sous-groupes plus grands ayant un plus grand poids dans l'estimation globale. Cette méthode donne une estimation plus précise de l'écart-type lorsque le procédé est stable.
- Use unbiasing constants for pooled sd : cette option ne s'applique que lorsque l'écart-type est estimé avec la méthode de l'écart-type groupé (Pooled Stdev).
- Check Rule 1: 1 point > K Stdev from center line : le test 1 est essentiel pour repérer les sous-groupes qui s'écartent nettement des autres ; c'est un outil universellement reconnu pour détecter les situations hors contrôle. Pour accroître la sensibilité et détecter de plus petits décalages du procédé, le test 2 peut être utilisé conjointement avec le test 1, ce qui renforce l'efficacité des cartes de contrôle.
- Check Rule 2: K points in a row on same side of center line : le test 2 détecte les changements de centrage ou de variation du procédé. Pour surveiller de petits décalages du procédé, il peut être utilisé conjointement avec le test 1 afin d'accroître la sensibilité des cartes de contrôle.
- Check Rule 3: K points in a row, all increasing or all decreasing : le test 3 est conçu pour repérer les tendances dans un procédé. Il recherche plus précisément une longue séquence de points consécutifs dont la valeur augmente ou diminue de façon constante, signe d'une tendance sous-jacente possible dans le comportement du procédé.
- Check Rule 4: K points in a row, alternating up and down : le test 4 est conçu pour repérer des variations systématiques dans un procédé. Idéalement, le motif de variation d'un procédé devrait être aléatoire. Toutefois, si un point échoue au test 4, la variation n'est peut-être pas aléatoire et suit un motif prévisible.
- Check Rule 5: K out of K + 1 points > 2 standard deviation from center line (same side) : le test 5 détecte de petits décalages du procédé.
- Check Rule 6: K out of K + 1 points > 1 standard deviation from center line (same side) :le test 6 détecte de petits décalages du procédé.
- Check Rule 7: K points in a row within 1 standard deviation of center line (either side) :le test 7 repère des motifs de variation qui peuvent être interprétés à tort comme la preuve d'une bonne maîtrise. Ce test détecte des limites de contrôle trop larges, souvent dues à des données stratifiées. Des données stratifiées apparaissent lorsqu'une source systématique de variation existe au sein de chaque sous-groupe, ce qui fait paraître les limites de contrôle plus larges qu'elles ne devraient l'être.
- Check Rule 8: K points in a row > 1 standard deviation from center line (either side) :le test 8 détecte un motif de mélange. Dans un motif de mélange, les points tendent à s'éloigner de la ligne centrale et à se situer près des limites de contrôle.
- Download as Excel : affiche le résultat au format Excel ; il peut être facilement modifié puis rechargé pour de nouveaux calculs avec l'option Load File.
Formule de la carte Xbar-R
Cette section décrit le calcul des limites de contrôle des cartes Xbar et R. Notez d'abord la description des termes utilisés dans les calculs qui suivent.
TermeDescription
x_{ij}
j-ième observation du i-ième sous-groupe
n_i
nombre d'observations du sous-groupe i
\sum x
somme de toutes les observations individuelles
\sum n
nombre total d'observations
μ
moyenne du procédé
k
paramètre du test 1 (3 par défaut)
σ
écart-type du procédé
d_2 (.)
valeur de la constante de correction du biais d2 correspondant à la valeur indiquée entre parenthèses
d_3 (.)
valeur de la constante de correction du biais d3 correspondant à la valeur indiquée entre parenthèses
r_i
étendue du sous-groupe i
m
nombre de sous-groupes
\overline x_i
moyenne du sous-groupe i
µ_ν
moyenne des variances des sous-groupes
c_4 (.)
valeur de la constante de correction du biais c4 correspondant à la valeur indiquée entre parenthèses
c_5 (.)
valeur de la constante de correction du biais c5 correspondant à la valeur indiquée entre parenthèses
Γ()
fonction gamma
Formule de la carte Xbar
- Points tracés : chaque point tracé, \overline x_i , représente la moyenne des observations du sous-groupe i .
\overline x_i = \frac{\sum\limits_{j=1}^{n_i} x_{ij}}{n_i}
- Ligne centrale : la ligne centrale représente la moyenne du procédé (µ).
\overline{\overline{X}} = \frac{∑x}{∑n}
- Limites de contrôle :
- Limite de contrôle inférieure : la valeur de la limite de contrôle inférieure de chaque sous-groupe i se calcule comme suit :
LCL_i= µ- \frac{kσ}{√(n_i )}
- Limite de contrôle supérieure : la valeur de la limite de contrôle supérieure de chaque sous-groupe i se calcule comme suit :
- Limite de contrôle supérieure : la valeur de la limite de contrôle supérieure de chaque sous-groupe i se calcule comme suit :
UCL_i= µ+ \frac{kσ}{√(n_i )}
Formule de la carte R
- Points tracés : chaque point tracé, r_i , représente l'étendue du sous-groupe i .
- Ligne centrale : la valeur de la ligne centrale de chaque sous-groupe, \overline R_i , se calcule comme suit :
\overline R_i= d_2(n_i) × σ
- Limite de contrôle :
- Limite de contrôle inférieure : la valeur de la limite de contrôle inférieure de chaque sous-groupe i est égale à la plus grande des valeurs suivantes :
LCL_i= [d_2(n_i) × σ] - [kσ×d_3(n_i)]
ou
LCL_i= 0
- Limite de contrôle supérieure : la valeur de la limite de contrôle supérieure de chaque sous-groupe i se calcule comme suit :
UCL_i= [d_2(n_i) × σ] + [kσ×d_3(n_i)]
Formule d'estimation de sigma (écart-type intra)
- On suppose souvent à tort que le σ utilisé dans les calculs ci-dessus est l'écart-type d'échantillon ou de population habituel, que l'on obtient avec les calculs standard d'un tableur. Il s'agit pourtant d'un écart-type estimé, fondé sur le principe qu'il faut utiliser l'écart-type propre au procédé, en excluant la variation inter-sous-groupes. Il existe deux méthodes courantes d'estimation de la variation intra-sous-groupe.
- Avec la méthode Rbar : nous utilisons l'étendue de chaque sous-groupe, r_i , pour calculer S_r , qui est un estimateur sans biais de σ:
S_r = \frac{\sum\limits_{i}^{} (\frac{f_i r_i}{d_2 (n_i)})}{\sum\limits_{i}^{} {f_i}}
où
f_i = \frac{[d_2 (n_i)]^2}{[d_3 (n_i)]^2}
Lorsque la taille de sous-groupe est constante, la formule se simplifie comme suit :
S_r = \frac{\overline R}{d_2 (n_i)}
où
\overline R = \frac{\sum r_i}{m}
- Avec la méthode de l'écart-type groupé : l'écart-type groupé (Sp) est donné par la formule suivante.
S_p = \sqrt\frac{\sum\limits_{i}^{} \sum\limits_{j}^{} (x_{ij}-\overline x_i)^2 }{\sum\limits_{i}^{} (n_{i}-1)}
Lorsque la taille de sous-groupe est constante, Sp peut aussi se calculer comme suit :
S_p = \sqrt µ_ν
Formules des constantes de correction du biais
- Les constantes de correction du biais utilisées dans les formules ci-dessus sont généralement tirées de tables statistiques standard. Toutefois, la formule suivante permet aussi de calculer les valeurs des constantes de correction du biais.
- d_2 () : pour des valeurs de N de 51 à 100, utilisez l'approximation suivante de d2(N) :
d_2 (N) = 3.4873 + 0.0250141 × N - 0.00009823 × N^2
- d_3 () et d_4 () : pour des valeurs de N de 26 à 100, utilisez les approximations suivantes de d3(N) et d4(N) :
d_3 (N) = 0.80818 - 0.0051871 × N + 0.00005098×N^2 - 0.00000019 × N^3
d_4 (N) = 2.88606 + 0.051313 × N - 0.00049243×N^2 + 0.00000188 × N^3
- c_4 () et c_5 () :
c_4 (N) = {\sqrt \frac {2}{N-1}}\frac{Γ\frac{N}{2}}{Γ\frac{N-1}{2}}
c_5 (N) = \sqrt {1 - c_4(N)^2}
Questions fréquentes
Qu'est-ce qu'une carte Xbar-R ?
Une carte Xbar-R est une paire de cartes de contrôle pour des données continues recueillies en sous-groupes à intervalles fixes. La carte Xbar surveille la moyenne du procédé et détecte ses décalages, tandis que la carte R surveille la variation du procédé à l'aide de l'étendue de chaque sous-groupe. Ensemble, elles montrent si le procédé est stable au fil du temps.
Quand utiliser une carte Xbar-R plutôt qu'une carte Xbar-S ?
Utilisez une carte Xbar-R lorsque la taille de sous-groupe est supérieure à un et de 8 ou moins. Pour des sous-groupes de 9 observations ou plus, utilisez une carte Xbar-S. S'il n'y a pas de sous-groupes, utilisez une carte I-MR, et pour des comptages d'unités défectueuses ou de défauts, une carte aux attributs comme la carte P ou la carte U.
Comment les limites de contrôle d'une carte Xbar-R sont-elles calculées ?
Sur la carte Xbar, les limites de chaque sous-groupe sont la moyenne du procédé plus ou moins k fois sigma divisé par la racine carrée de la taille de sous-groupe, avec k = 3 par défaut. Sur la carte R, la ligne centrale est d2 fois sigma, et les limites sont d2 fois sigma plus ou moins k fois sigma fois d3, la limite inférieure ne descendant pas sous zéro.
Comment sigma est-il estimé pour une carte Xbar-R ?
Sigma est l'écart-type intra-sous-groupe, et non l'écart-type d'échantillon ordinaire : la variation inter-sous-groupes est donc exclue. Avec la méthode Rbar et une taille de sous-groupe constante, sigma est l'étendue moyenne divisée par d2. La méthode de l'écart-type groupé utilise à la place la moyenne pondérée des variances des sous-groupes.