
Xbar-R-Karte (X̄-R-Karte)
Xbar-R-Karten sind unverzichtbare Werkzeuge, um in vielen Branchen die Stabilität von Prozessen mit variablen Daten zu überwachen. Diese Karten eignen sich besonders, um stetige Daten zu untersuchen und die Prozessleistung zu beurteilen.
Zuletzt geprüft
Kernaussage
Xbar-R-Karten sind unverzichtbare Werkzeuge, um in vielen Branchen die Stabilität von Prozessen mit variablen Daten zu überwachen.
Auf dieser Seite
Was ist eine Xbar-R-Karte?
Xbar-R-Karten sind unverzichtbare Werkzeuge, um in vielen Branchen die Stabilität von Prozessen mit variablen Daten zu überwachen. Diese Karten eignen sich besonders, um stetige Daten zu untersuchen und die Prozessleistung zu beurteilen. Aus Daten von Teilgruppen, die in festen Abständen erfasst werden, liefern Xbar-R-Karten zwei Diagramme: eines zur Überwachung des Prozessmittelwerts (Xbar-Karte) und eines zur Überwachung der Prozessstreuung (R-Karte) im zeitlichen Verlauf.
Xbar-R-Karten sind entscheidend, um Schwankungen sowohl des Prozessmittelwerts als auch der Spannweite zu erkennen. Sie sind wichtig, um die Wirkung von Maßnahmen zur Prozessverbesserung zu beurteilen. Die Xbar-Karte erkennt Verschiebungen des Prozessmittelwerts, die R-Karte hebt Änderungen der Prozessstreuung hervor. Zusammen ermöglichen sie eine umfassende Lenkung und Beurteilung der Prozessbeständigkeit im zeitlichen Verlauf. Sie helfen, Trends und Muster zu erkennen, die auf zugrunde liegende Probleme im Prozess hindeuten können. Durch eine klare visuelle Darstellung des Prozessverhaltens unterstützen diese Karten datengestützte Entscheidungen und kontinuierliche Verbesserung. Besonders wertvoll sind sie in Umgebungen, in denen eine enge Lenkung der Prozessparameter entscheidend für Produktqualität und betriebliche Effizienz ist.
Wann wird eine Xbar-R-Karte eingesetzt?
Die Xbar-R-Karte wird eingesetzt, wenn die Teilgruppengröße größer als eins und der Stichprobenumfang klein oder mittel ist (unter 10). Mit ihr werden die zentrale Tendenz (Mittelwert) und die Streuung (Spannweite) eines Prozesses im zeitlichen Verlauf überwacht, wenn eine Normalverteilung angenommen werden kann. Die Xbar-R-Karte hilft, Änderungen des Prozessmittelwerts und der Streuung zu erkennen, die auf Verbesserungsbedarf im Prozess hinweisen können. Sie wird häufig in der Fertigung und in anderen Branchen eingesetzt, in denen Qualitätslenkung wichtig ist.
Hinweise zur richtigen Anwendung der Xbar-R-Karte
- Verwenden Sie stetige Daten für Regelkarten für variable Daten und attributive Daten für die P-Karte oder die U-Karte.
- Geben Sie die Daten in zeitlicher Reihenfolge ein, die ältesten Daten oben.
- Erfassen Sie die Daten in gleichen zeitlichen Abständen.
- Verwenden Sie rationale Teilgruppen, also kleine Stichproben gleichartiger Einheiten, die unter denselben Bedingungen gefertigt wurden.
- Die Teilgruppengröße sollte 8 oder weniger betragen; für größere Teilgruppen verwenden Sie die Xbar-S-Karteund ohne Teilgruppen die I-MR-Karte .
- Erfassen Sie je nach Teilgruppengröße eine angemessene Datenmenge.
- Regelkarten können auch bei nicht normalverteilten Daten funktionieren, wenn diese in Teilgruppen erfasst werden.
- Vermeiden Sie korrelierte Datenpunkte innerhalb der Teilgruppen, damit die Eingriffsgrenzen nicht zu eng werden.
Alternativen: Wann Sie keine Xbar-R-Karte verwenden sollten
- Für Teilgruppen mit 9 oder mehr Beobachtungen wählen Sie die Xbar-S-Karte, es sei denn, es gibt eine beständige Streuungsquelle innerhalb der Teilgruppen; verwenden Sie in diesem Fall die I-MR-R/S-Karte.
- Gibt es keine Teilgruppen, verwenden Sie die I-MR-Karte.
- Betreffen Ihre Daten Anzahlen fehlerhafter Einheiten oder Fehler, verwenden Sie eine Regelkarte für attributive Daten, etwa die P-Karte oder die U-Karte.
Beispiel für eine Xbar-R-Karte
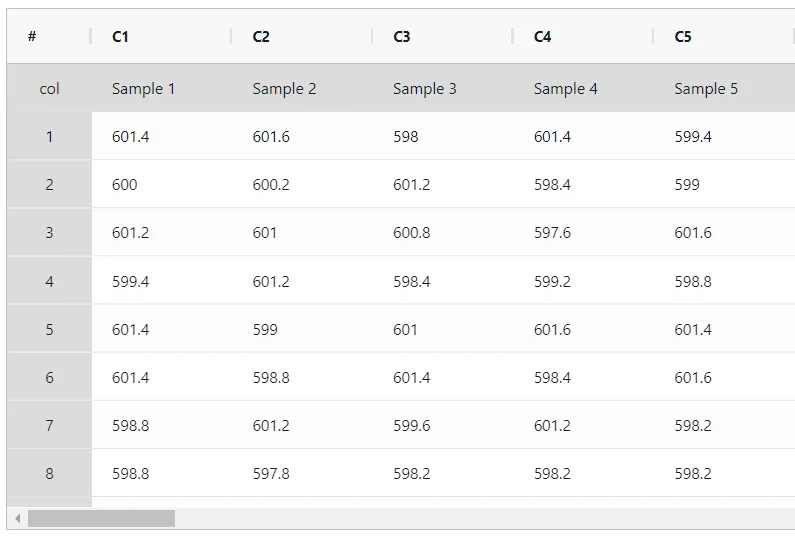
Sehen wir uns anhand eines Beispiels an, wie eine Xbar-Karte und eine R-Karte erstellt werden. Angenommen, ein Ingenieur möchte einen Fertigungsprozess überwachen, in dem Nockenwellen für einen Automobil-OEM-Kunden hergestellt werden. In jeder Teilgruppe wurden 5 Proben entnommen. Eine Teilgruppe besteht aus Proben, die innerhalb kurzer Zeit entnommen werden, typischerweise aufeinanderfolgende Teile von einer einzelnen Fertigungsmaschine. Die Daten der Teilgruppen wurden etwa alle 30 Minuten erfasst. Folgende Daten wurden erfasst:
- Er hat die erforderlichen Daten erfasst.
2. Nun analysiert er die Daten in Zometric Statistical Software unter https://statsai.zometric.com/.
3. Um die Xbar-R-Karte aufzurufen, wählen Sie Statistical module> Control Charts> X Bar R Chart.
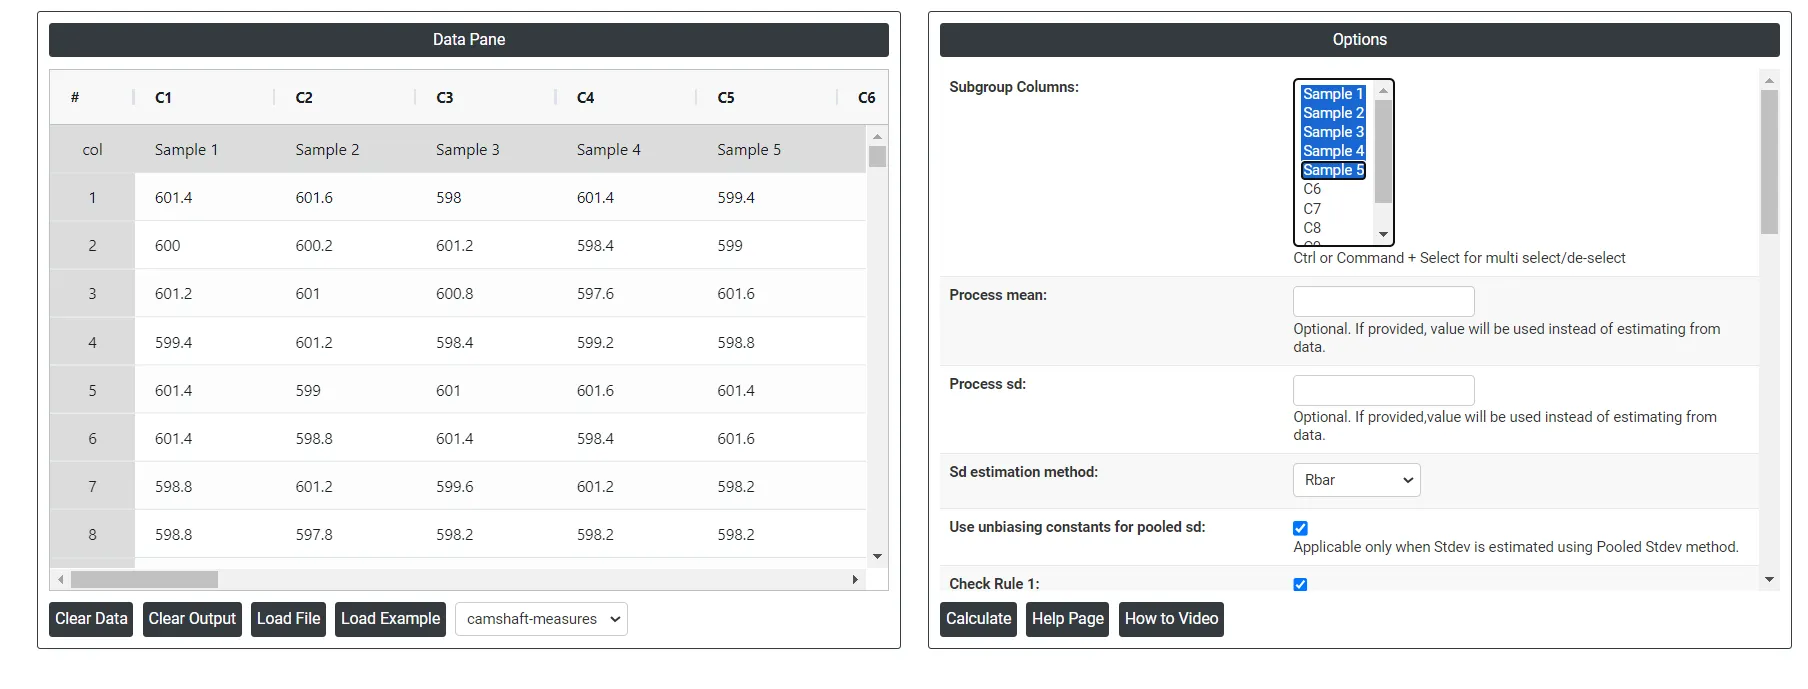
4. Im Werkzeug gibt er die Daten zusammen mit den weiteren Eingaben wie folgt ein:
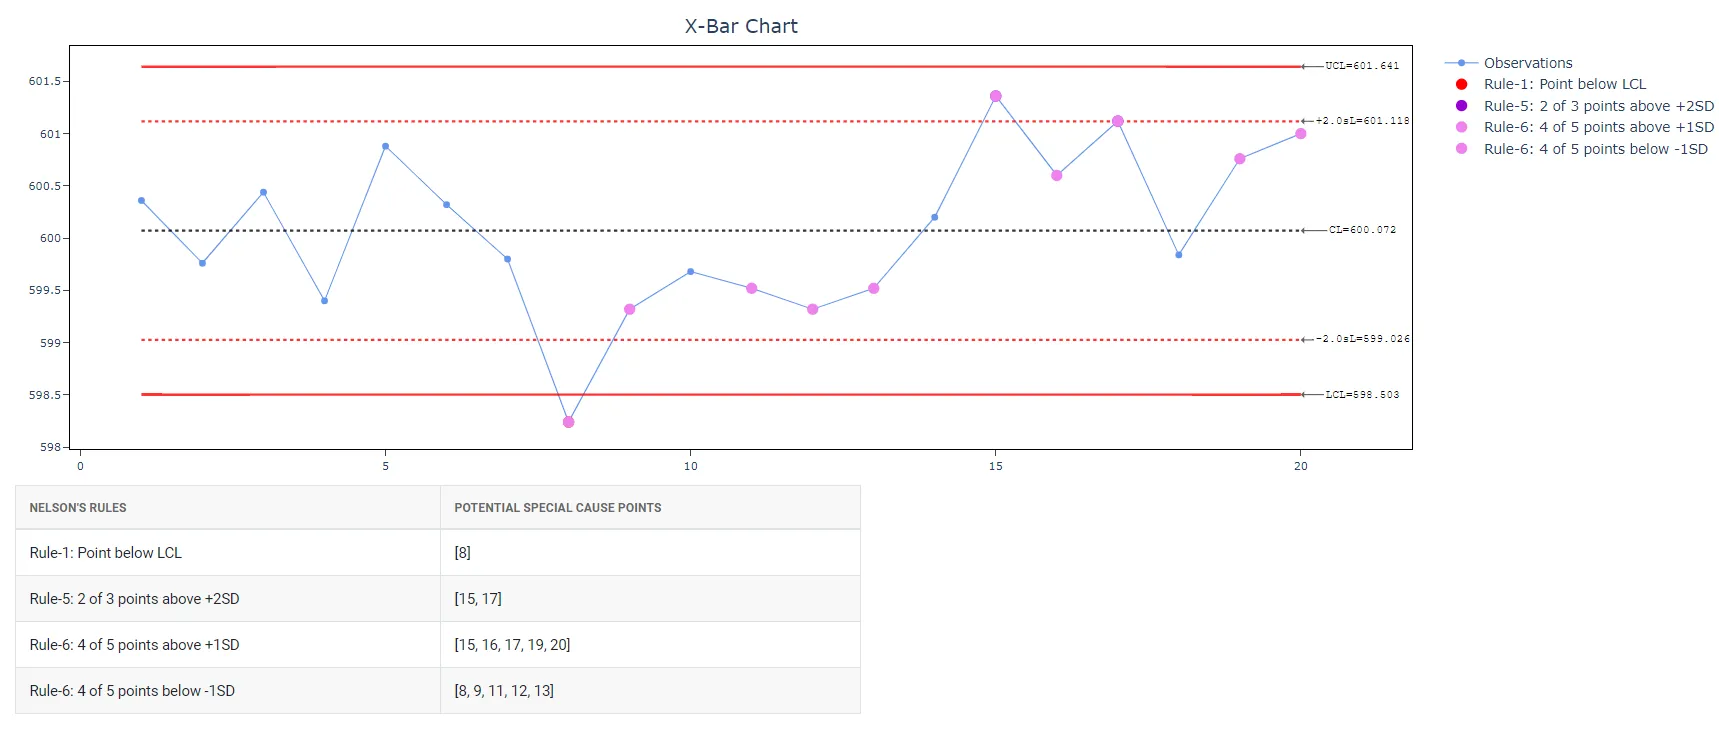
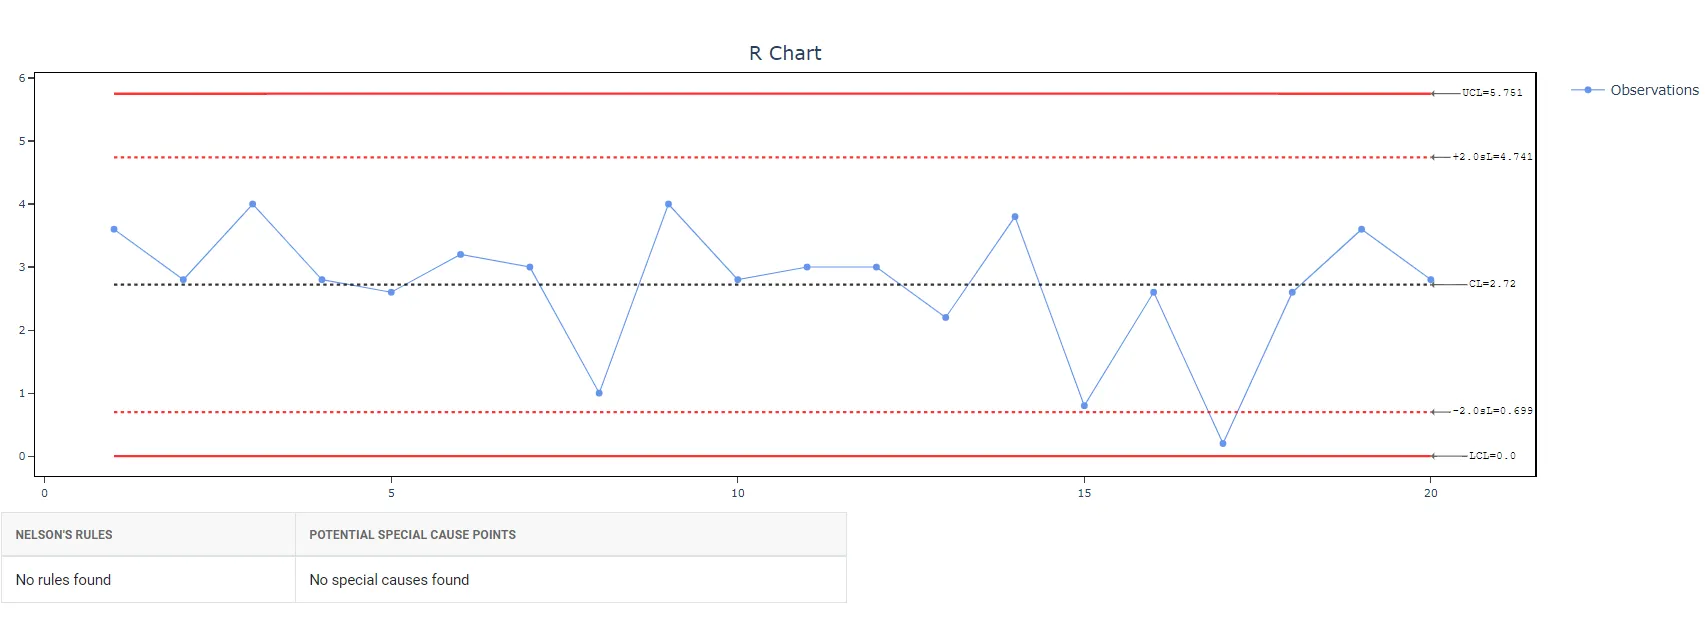
5. Nach Ausführung des oben genannten Werkzeugs erhält er folgende Ausgabe:
Anleitung: Xbar-R-Karte erstellen
So gehen Sie vor:
- Melden Sie sich bei Ihrer Zometric Statistical Software an unter https://statsai.zometric.com/
- Wählen Sie auf der Startseite Statistical Tool> Control Charts >Xbar R Chart.
- Klicken Sie auf Xbar-R Chart , um zum Dashboard zu gelangen.
- Geben Sie die Daten anschließend manuell ein, oder kopieren Sie die Daten vollständig (Strg+C) aus einer Excel-Tabelle und fügen Sie sie hier ein (Strg+V).
- Wählen Sie anschließend die Sd estimation method sowie die gewünschten Check Rules.
- Klicken Sie abschließend unten auf der Seite auf calculate, um die gewünschten Ergebnisse zu erhalten.
Das Dashboard der Xbar-R-Karte ist in zwei Bereiche unterteilt.
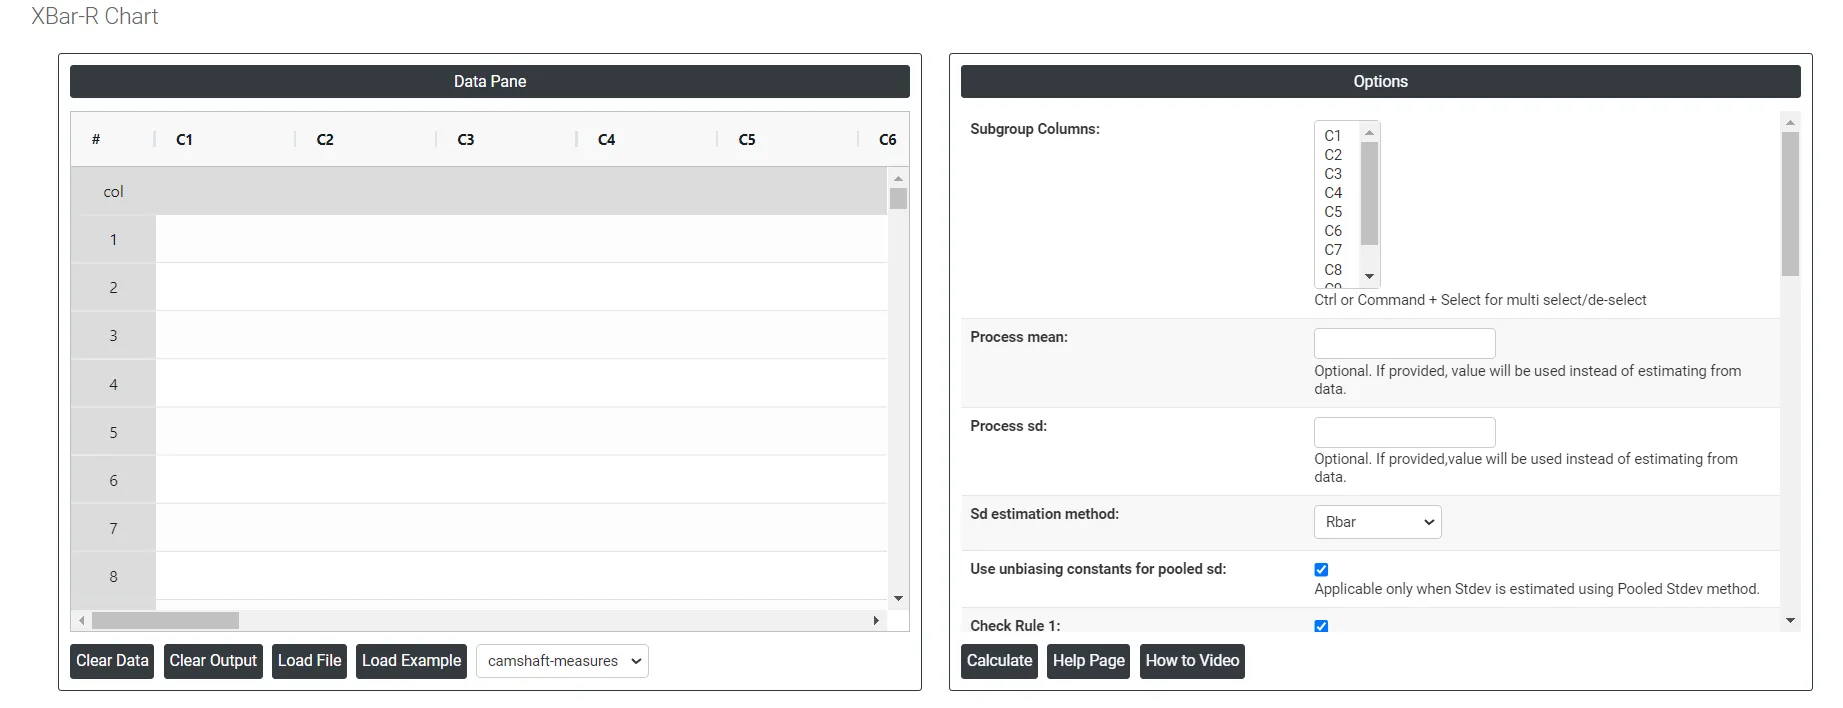
Im linken Bereich befindet sich der Datenbereich (Data Pane). Im Data Pane bildet jede Zeile eine Teilgruppe. Die Daten können manuell eingegeben oder vollständig aus einer Excel-Tabelle kopiert (Strg+C) und hier eingefügt (Strg+V) werden.
Load example: Es werden Beispieldaten geladen.
Load File: Damit werden Excel-Daten direkt geladen.
Im rechten Bereich stehen folgende Optionen zur Verfügung:
- Process mean: Der Mittelwert einer Reihe von Messungen oder Beobachtungen aus einem Prozess. Er stellt die zentrale Tendenz der Prozessdaten im zeitlichen Verlauf dar und ist ein wichtiger Indikator für die Prozessleistung. Wird er nicht angegeben, berechnet Zometric Statistical Software die Mittellinie aus den bereitgestellten Daten.
- Process sd: Ein Maß für die Streuung der Prozessdaten um den Mittelwert. Sie zeigt, wie stark einzelne Datenpunkte des Prozesses vom Prozessmittelwert abweichen. Wird sie nicht angegeben, berechnet Zometric Statistical Software sie aus den bereitgestellten Daten.
- Sd estimation method: Hier stehen zwei Berechnungsverfahren zur Auswahl. Ob Sie Rbar oder die Methode der gepoolten Standardabweichung als Schätzverfahren wählen, verändert das Ergebnis.
- Rbar Sd estimation method: Rbar ist der Mittelwert der Spannweiten innerhalb der Teilgruppen. Die Rbar-Methode ist eine weit verbreitete Schätzung der Standardabweichung und besonders wirksam bei Teilgruppengrößen von 2 bis 8.
- Pooled Sd estimation method: Die gepoolte Standardabweichung ist der gewichtete Mittelwert der Varianzen der Teilgruppen, wobei größere Teilgruppen stärker in die Gesamtschätzung eingehen. Diese Methode liefert eine genauere Schätzung der Standardabweichung, wenn der Prozess stabil ist.
- Use unbiasing constants for pooled sd: Diese Option gilt nur, wenn die Standardabweichung mit der Methode Pooled Stdev geschätzt wird.
- Check Rule 1: 1 point > K Stdev from center line: Test 1 ist unverzichtbar, um Teilgruppen zu erkennen, die deutlich von den übrigen abweichen, und ist daher ein allgemein anerkanntes Werkzeug zur Erkennung von Zuständen außer Kontrolle. Um die Empfindlichkeit zu erhöhen und kleinere Prozessverschiebungen zu erkennen, kann Test 2 zusammen mit Test 1 verwendet werden; das steigert die Wirksamkeit der Regelkarten.
- Check Rule 2: K points in a row on same side of center line: Test 2 erkennt Änderungen der Prozesslage oder der Streuung. Bei der Überwachung kleiner Prozessverschiebungen kann Test 2 zusammen mit Test 1 verwendet werden, um die Empfindlichkeit der Regelkarten zu erhöhen.
- Check Rule 3: K points in a row, all increasing or all decreasing: Test 3 dient dazu, Trends in einem Prozess zu erkennen. Dieser Test sucht gezielt nach einer längeren Folge aufeinanderfolgender Datenpunkte, deren Werte stetig steigen oder fallen, was auf einen möglichen zugrunde liegenden Trend im Prozessverhalten hinweist.
- Check Rule 4: K points in a row, alternating up and down: Test 4 dient dazu, systematische Schwankungen in einem Prozess zu erkennen. Idealerweise sollte das Streuungsmuster eines Prozesses zufällig sein. Schlägt ein Punkt bei Test 4 an, kann das darauf hindeuten, dass die Streuung nicht zufällig ist, sondern einem vorhersagbaren Muster folgt.
- Check Rule 5: K out of K + 1 points > 2 standard deviation from center line (same side): Test 5 erkennt kleine Verschiebungen im Prozess.
- Check Rule 6: K out of K + 1 points > 1 standard deviation from center line (same side):Test 6 erkennt kleine Verschiebungen im Prozess.
- Check Rule 7: K points in a row within 1 standard deviation of center line (either side):Test 7 erkennt Streuungsmuster, die fälschlich als Beleg für eine gute Prozessbeherrschung gedeutet werden können. Dieser Test erkennt zu weite Eingriffsgrenzen, die häufig auf geschichtete Daten zurückgehen. Geschichtete Daten entstehen, wenn innerhalb jeder Teilgruppe eine systematische Streuungsquelle vorliegt, sodass die Eingriffsgrenzen weiter erscheinen, als sie sein sollten.
- Check Rule 8: K points in a row > 1 standard deviation from center line (either side):Test 8 erkennt ein Mischungsmuster. Bei einem Mischungsmuster meiden die Punkte die Mittellinie und liegen stattdessen nahe den Eingriffsgrenzen.
- Download as Excel: Gibt das Ergebnis im Excel-Format aus, das sich leicht bearbeiten und über die Option load file erneut für Berechnungen laden lässt.
Formel der Xbar-R-Karte
In diesem Abschnitt wird beschrieben, wie die Eingriffsgrenzen der Xbar-Karte und der R-Karte berechnet werden. Beachten Sie zunächst die Beschreibung der in den folgenden Berechnungen verwendeten Größen.
BegriffBeschreibung
x_{ij}
j-te Beobachtung in der i-ten Teilgruppe
n_i
Anzahl der Beobachtungen in Teilgruppe i
\sum x
Summe aller Einzelbeobachtungen
\sum n
Gesamtzahl der Beobachtungen
μ
Prozessmittelwert
k
Parameter für Test 1 (Standardwert ist 3)
σ
Prozessstandardabweichung
d_2 (.)
Wert der Korrekturkonstante d2 , der dem in Klammern angegebenen Wert entspricht
d_3 (.)
Wert der Korrekturkonstante d3 , der dem in Klammern angegebenen Wert entspricht
r_i
Spannweite der Teilgruppe i
m
Anzahl der Teilgruppen
\overline x_i
Mittelwert der Teilgruppe i
µ_ν
Mittelwert der Varianzen der Teilgruppen
c_4 (.)
Wert der Korrekturkonstante c4 , der dem in Klammern angegebenen Wert entspricht
c_5 (.)
Wert der Korrekturkonstante c5 , der dem in Klammern angegebenen Wert entspricht
Γ()
Gammafunktion
Formel für die Xbar-Karte
- Dargestellte Punkte: Jeder dargestellte Punkt \overline x_i stellt den Mittelwert der Beobachtungen der Teilgruppe i dar.
\overline x_i = \frac{\sum\limits_{j=1}^{n_i} x_{ij}}{n_i}
- Mittellinie: Die Mittellinie stellt den Prozessmittelwert (µ) dar.
\overline{\overline{X}} = \frac{∑x}{∑n}
- Eingriffsgrenzen:
- Untere Eingriffsgrenze: Der Wert der unteren Eingriffsgrenze für jede Teilgruppe i wird wie folgt berechnet:
LCL_i= µ- \frac{kσ}{√(n_i )}
- Obere Eingriffsgrenze: Der Wert der oberen Eingriffsgrenze für jede Teilgruppe i wird wie folgt berechnet:
- Obere Eingriffsgrenze: Der Wert der oberen Eingriffsgrenze für jede Teilgruppe i wird wie folgt berechnet:
UCL_i= µ+ \frac{kσ}{√(n_i )}
Formel für die R-Karte
- Dargestellte Punkte: Jeder dargestellte Punkt r_i stellt die Spannweite der Teilgruppe i dar.
- Mittellinie: Der Wert der Mittellinie für jede Teilgruppe, \overline R_i , wird wie folgt berechnet:
\overline R_i= d_2(n_i) × σ
- Eingriffsgrenze:
- Untere Eingriffsgrenze: Der Wert der unteren Eingriffsgrenze für jede Teilgruppe i ist der größere der folgenden Werte:
LCL_i= [d_2(n_i) × σ] - [kσ×d_3(n_i)]
oder
LCL_i= 0
- Obere Eingriffsgrenze: Der Wert der oberen Eingriffsgrenze für jede Teilgruppe i wird wie folgt berechnet:
UCL_i= [d_2(n_i) × σ] + [kσ×d_3(n_i)]
Formel zur Schätzung von Sigma (Standardabweichung innerhalb der Teilgruppen)
- Häufig wird fälschlich angenommen, das in den obigen Berechnungen verwendete σ sei die übliche Standardabweichung der Stichprobe oder der Grundgesamtheit, wie sie mit Standardfunktionen einer Tabellenkalkulation berechnet werden kann. Beachten Sie jedoch, dass es sich um eine geschätzte Standardabweichung handelt, die auf dem Prinzip beruht, nur die dem Prozess inhärente Standardabweichung zu verwenden und die Streuung zwischen den Teilgruppen auszuschließen. Es gibt zwei gängige Methoden zur Schätzung der Streuung innerhalb der Teilgruppen.
- Mit der Rbar-Methode: Aus der Spannweite jeder Teilgruppe, r_i , wird S_r berechnet, ein erwartungstreuer Schätzer für σ:
S_r = \frac{\sum\limits_{i}^{} (\frac{f_i r_i}{d_2 (n_i)})}{\sum\limits_{i}^{} {f_i}}
wobei
f_i = \frac{[d_2 (n_i)]^2}{[d_3 (n_i)]^2}
Bei konstanter Teilgruppengröße vereinfacht sich die Formel wie folgt:
S_r = \frac{\overline R}{d_2 (n_i)}
wobei
\overline R = \frac{\sum r_i}{m}
- Mit der Methode der gepoolten Standardabweichung: Die gepoolte Standardabweichung (Sp) ergibt sich aus folgender Formel.
S_p = \sqrt\frac{\sum\limits_{i}^{} \sum\limits_{j}^{} (x_{ij}-\overline x_i)^2 }{\sum\limits_{i}^{} (n_{i}-1)}
Bei konstanter Teilgruppengröße lässt sich Sp auch wie folgt berechnen:
S_p = \sqrt µ_ν
Formeln für die Korrekturkonstanten
- Die in den obigen Formeln verwendeten Korrekturkonstanten werden üblicherweise aus statistischen Standardtabellen entnommen. Die Werte der Korrekturkonstanten lassen sich jedoch auch mit den folgenden Formeln berechnen.
- d_2 () : Für Werte von N von 51 bis 100 verwenden Sie folgende Näherung für d2(N):
d_2 (N) = 3.4873 + 0.0250141 × N - 0.00009823 × N^2
- d_3 () und d_4 () : Für Werte von N von 26 bis 100 verwenden Sie folgende Näherungen für d3(N) und d4(N):
d_3 (N) = 0.80818 - 0.0051871 × N + 0.00005098×N^2 - 0.00000019 × N^3
d_4 (N) = 2.88606 + 0.051313 × N - 0.00049243×N^2 + 0.00000188 × N^3
- c_4 () und c_5 () :
c_4 (N) = {\sqrt \frac {2}{N-1}}\frac{Γ\frac{N}{2}}{Γ\frac{N-1}{2}}
c_5 (N) = \sqrt {1 - c_4(N)^2}
Häufig gestellte Fragen
Was ist eine Xbar-R-Karte?
Eine Xbar-R-Karte ist ein Paar von Regelkarten für stetige Daten, die in Teilgruppen in festen Abständen erfasst werden. Die Xbar-Karte überwacht den Prozessmittelwert und erkennt dessen Verschiebungen, die R-Karte überwacht die Prozessstreuung anhand der Spannweite jeder Teilgruppe. Zusammen zeigen sie, ob der Prozess im zeitlichen Verlauf stabil ist.
Wann sollte man eine Xbar-R-Karte statt einer Xbar-S-Karte verwenden?
Verwenden Sie eine Xbar-R-Karte, wenn die Teilgruppengröße größer als eins und höchstens 8 ist. Für Teilgruppen mit 9 oder mehr Beobachtungen verwenden Sie eine Xbar-S-Karte. Gibt es keine Teilgruppen, verwenden Sie eine I-MR-Karte, und für Anzahlen fehlerhafter Einheiten oder Fehler eine Regelkarte für attributive Daten wie eine P-Karte oder U-Karte.
Wie werden die Eingriffsgrenzen der Xbar-R-Karte berechnet?
In der Xbar-Karte sind die Grenzen für jede Teilgruppe der Prozessmittelwert plus oder minus k mal Sigma geteilt durch die Quadratwurzel der Teilgruppengröße, mit standardmäßig k = 3. In der R-Karte ist die Mittellinie d2 mal Sigma, und die Grenzen sind d2 mal Sigma plus oder minus k mal Sigma mal d3, wobei die untere Grenze nicht unter null liegt.
Wie wird Sigma für eine Xbar-R-Karte geschätzt?
Sigma ist die Standardabweichung innerhalb der Teilgruppen, nicht die gewöhnliche Stichprobenstandardabweichung; die Streuung zwischen den Teilgruppen wird also ausgeschlossen. Mit der Rbar-Methode und konstanter Teilgruppengröße ist Sigma die mittlere Spannweite geteilt durch d2. Die Methode der gepoolten Standardabweichung verwendet stattdessen den gewichteten Mittelwert der Varianzen der Teilgruppen.