
Xbar-S管理図
Xbar-S管理図は、9個以上の観測値からなる合理的なサブグループで収集した計量値データについて、工程の平均と工程のばらつきの両方を監視します。サブグループサイズが2〜8の場合はXbar-R管理図を、サブグループがない場合はI-MR管理図を使用します。観測値は時間順に60個以上収集します。シグマはSbar法または併合標準偏差法で推定され、検定ルールによって特殊原因が検出されます。
最終レビュー
重要なポイント
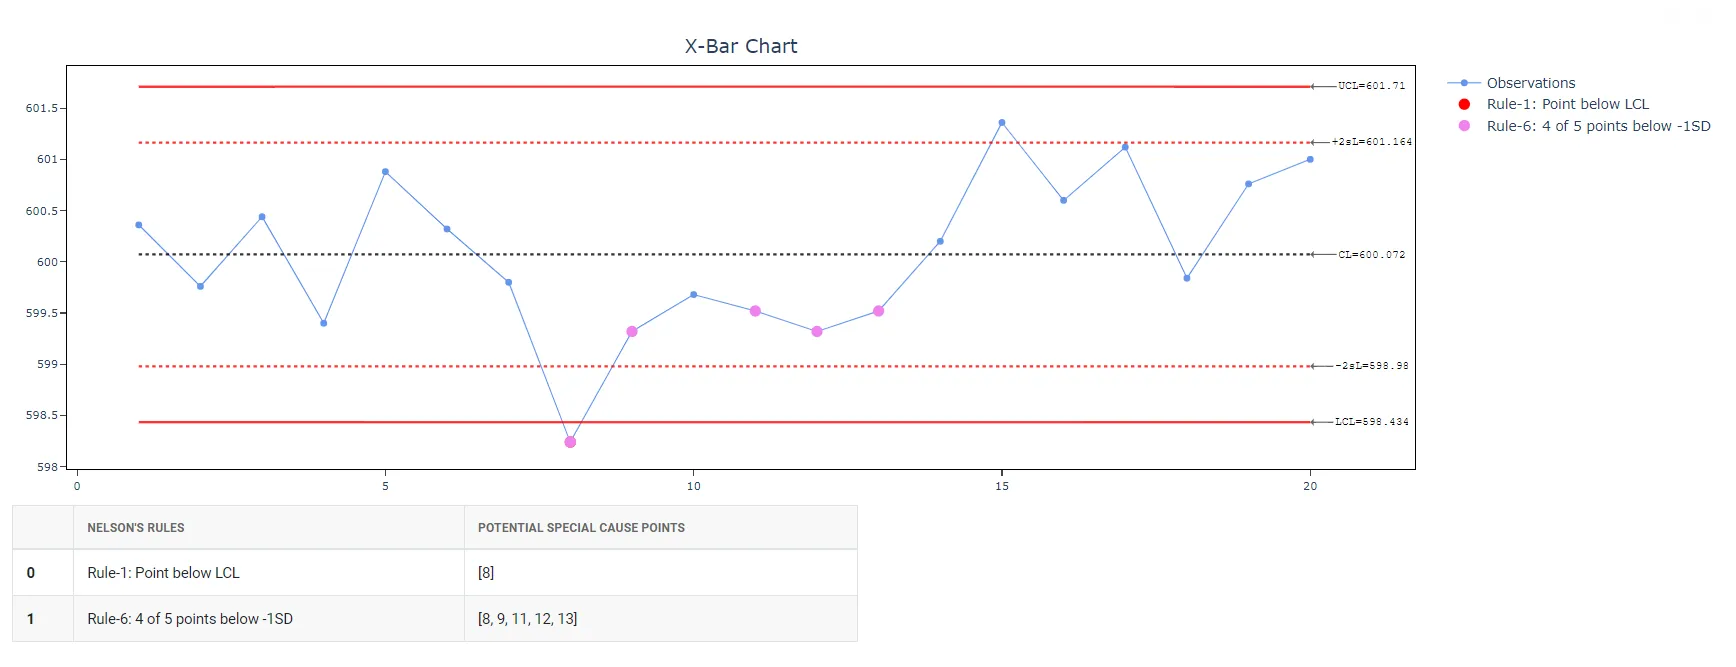
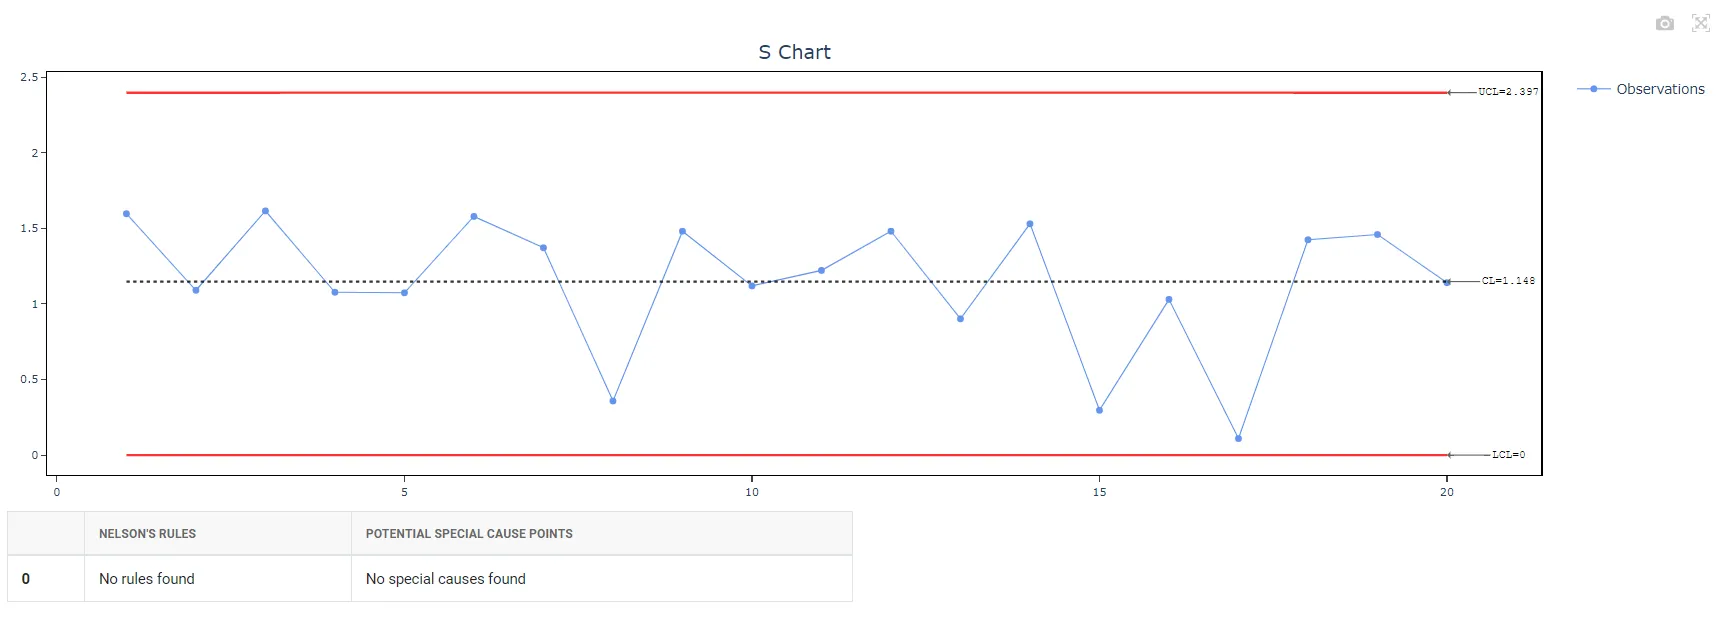
Xbar-S管理図は、大きさ9以上のサブグループで得られる計量値データ用の一対の管理図です。Xbar管理図はサブグループの平均を、S管理図はサブグループの標準偏差を時系列で追跡します。
このページの内容
Xbar-S管理図とは
Xbar-S管理図は、計量値データでサブグループサイズが9以上の場合に、工程の平均とばらつきを監視するために設計された高度な統計的管理ツールです。この管理図は2つの主要な要素で構成されます。1つは平均値を時系列で追跡して工程平均のシフトを特定するXbar管理図、もう1つは標準偏差を時系列で表示して工程のばらつきの変化を検出するS管理図です。
Xbar-S管理図は、サンプルサイズが大きい場合に特に有利で、範囲に基づく管理図と比べてデータの広がりをより正確に把握できます。品質管理や工程改善の場面で広く利用され、工程の安定を確保し、潜在的な問題を速やかに特定して対処するために役立ちます。Xbar-S管理図は、工程データの変動と傾向を明らかにすることで、工程性能全体の維持と向上に重要な役割を果たします。
Xbar-S管理図を使用する場面
- 合理的なサブグループ分け:測定値を論理的にグループ(サブグループ)として収集でき、それぞれが特定の時点における工程の「スナップショット」を表す場合。
- 時間順のデータ:工程の傾向やシフトを正確に検出するため、データが時間順、つまり発生した順序で入力されている場合。
- サブグループサイズが9以上:サブグループが大きくなるほど範囲の統計量は工程シグマの推定量として効率が低下するため、サブグループサイズが9以上の場合はXbar管理図とS管理図を選択します。サブグループの標準偏差(シグマ)は、サブグループの範囲よりも優れた変動の推定値を与えます。
- 連続かつ正規分布に従うデータ:収集したデータが連続で、正規分布に従う場合。
- 大きなシフトの検出:工程平均の比較的大きなシフト、一般に±1.5シグマ以上のシフトを検出する必要がある場合。Xbar管理図とS管理図はこの目的に効率的です。
- 感度の向上:シフトに対する感度を高めたい場合、特にサブグループが大きい場合には、合理的なサブグループを形成できることを前提として、Xbar管理図とS管理図の方が効果的です。
- 不安定な工程:工程が安定していない場合、つまり工程の平均と標準偏差が未知であるか、時間とともに変化している場合。
- 業界での適用:製造、医療、金融サービスなど、工程の品質管理が重要なさまざまな業界に適しています。
サブグループサイズが1の場合は、より適切な監視のために、個別値X/移動範囲管理図、EWMA管理図、CUSUM管理図の使用を検討してください。工程の小さなシフトに対する感度を高めたい場合は、EWMA管理図またはCUSUM管理図を推奨します。
Xbar-S管理図を正しく使用するためのガイドライン
- 不良品数や欠点数には、p管理図 や u管理図などの計数値管理図を使用してください。
- 時間の経過に伴う変化を検出するため、データは時間順に入力してください。
- 変化が起きた後すぐに特定できるよう、データは等間隔の時間で収集してください。
- 工程の出力を代表する合理的なサブグループを使用してください。
- 観測値が2〜8個のサブグループには Xbar-R管理図 を、9個以上のサブグループには Xbar-S管理図 を、サブグループがない場合は I-MR管理図 を使用してください。
- 信頼できる結果を得るため、観測値は合計で60個以上収集してください。
- 非正規データでも、適切な大きさのサブグループであれば良好な結果が得られます。
- 正確な管理限界を得るため、サブグループ内の観測値に相関がないようにしてください。
代替手法:Xbar-S管理図を使用すべきでない場合
- サブグループに含まれる観測値が2〜8個の場合は、Xbar-R管理図を使用するのが最適です。
- サブグループ内に一貫した変動要因がある場合は、I-MR-R/S管理図の方が適しています。
- サブグループがない場合は、I-MR管理図を使用してください。
- 不良品や欠点のデータを扱う場合は、p管理図 や u管理図などの計数値管理図の使用を推奨します。
Xbar-S管理図の例
ある缶詰会社の缶充填工程で、品質エンジニアが缶の重量を監視し、工程が管理状態にあるかどうかを判断しようとしています。エンジニアは1時間ごとに10缶からなるサブグループを収集し、サブグループ内変動を小さくするため、缶を短時間のうちに収集するようにしています。重量を追跡するため、品質エンジニアはXbar-S管理図を作成します。手順は次のとおりです。
- 1日を通して作業し、1時間ごとの各サブグループについて10缶の重量を記録しました。
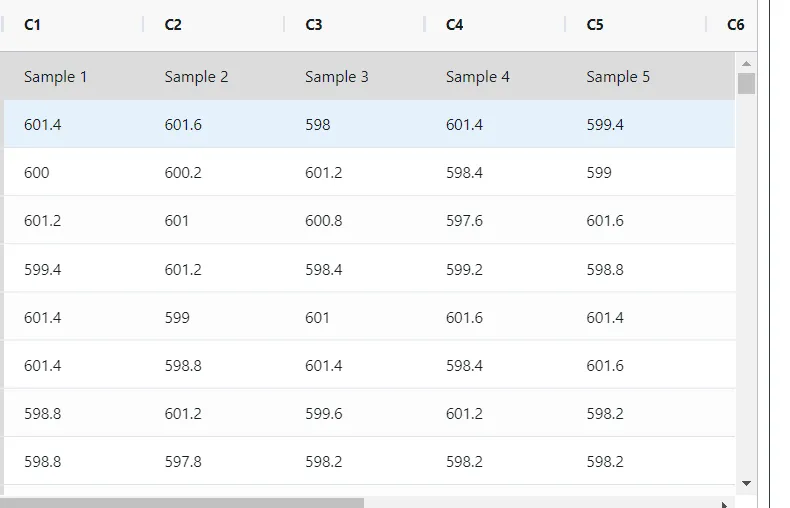
- 次に、次のサイトでデータを分析します:https://statsai.zometric.com/
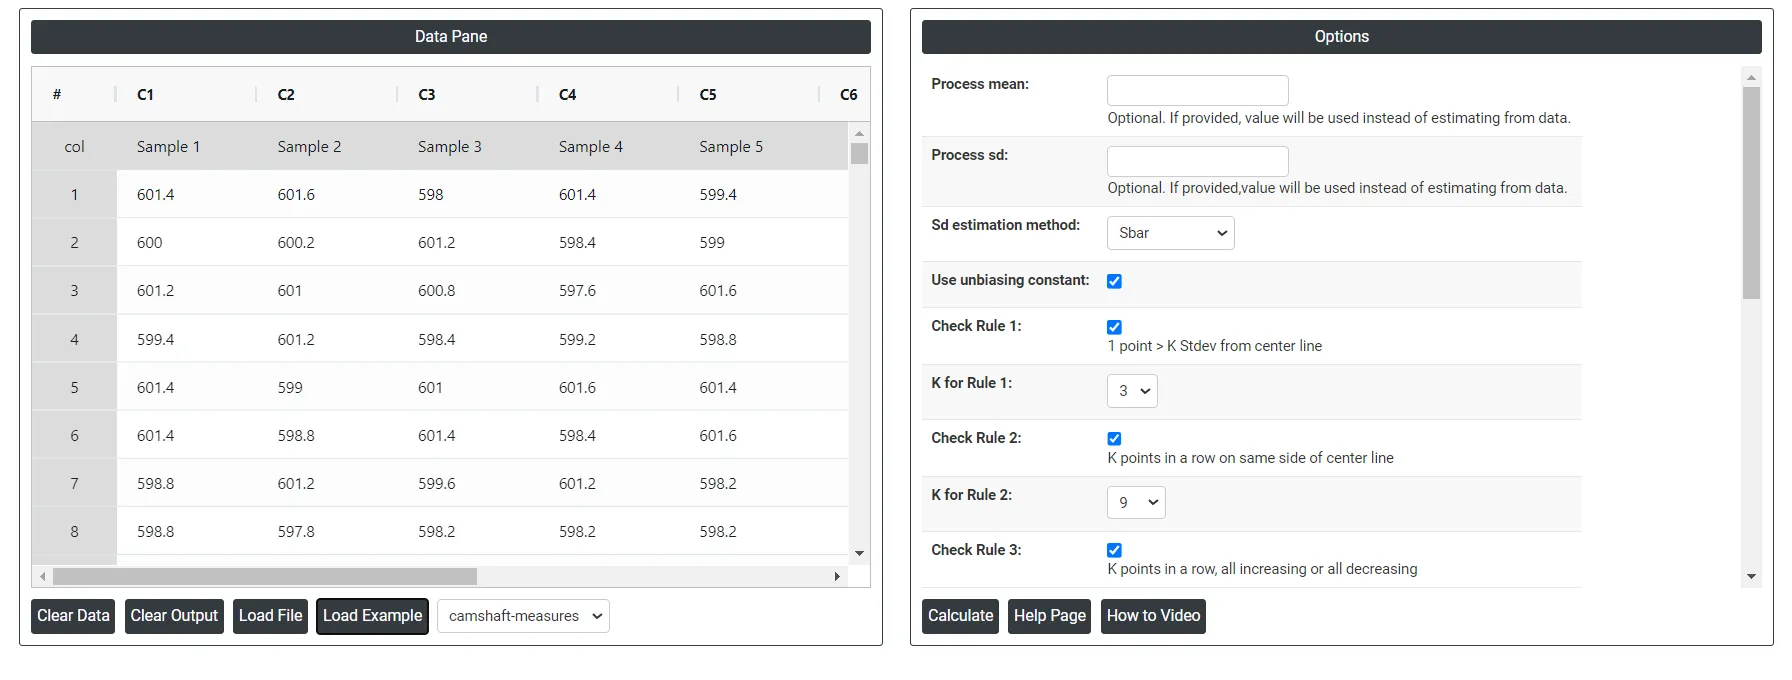
- ツール内でデータを入力します。また、sd estimation methodとしてSbarを選択します。
- 上記のツールを使用すると、次のような有用なグラフが得られます。
Xbar-S管理図の作成方法
手順は次のとおりです。
- Zometric Statistical Softwareにログインします:https://statsai.zometric.com/
- ホーム画面でStatistical Tool> Control Charts > Xbar-S Chartを選択します。
- 次に Xbar-S Chart をクリックしてダッシュボードを開きます。
- 次に、データを手動で入力するか、Excelシートからデータ全体をコピー(Ctrl+C)して貼り付けます(Ctrl+V)。または、Load Exampleオプションを使うとサンプルデータが読み込まれます。
- 次に、列をパラメーターに割り当てます。
- 最後に、ページ下部のcalculateをクリックすると、目的の結果が得られます。
Xbar-S管理図のダッシュボードでは、画面が2つの部分に分かれています。
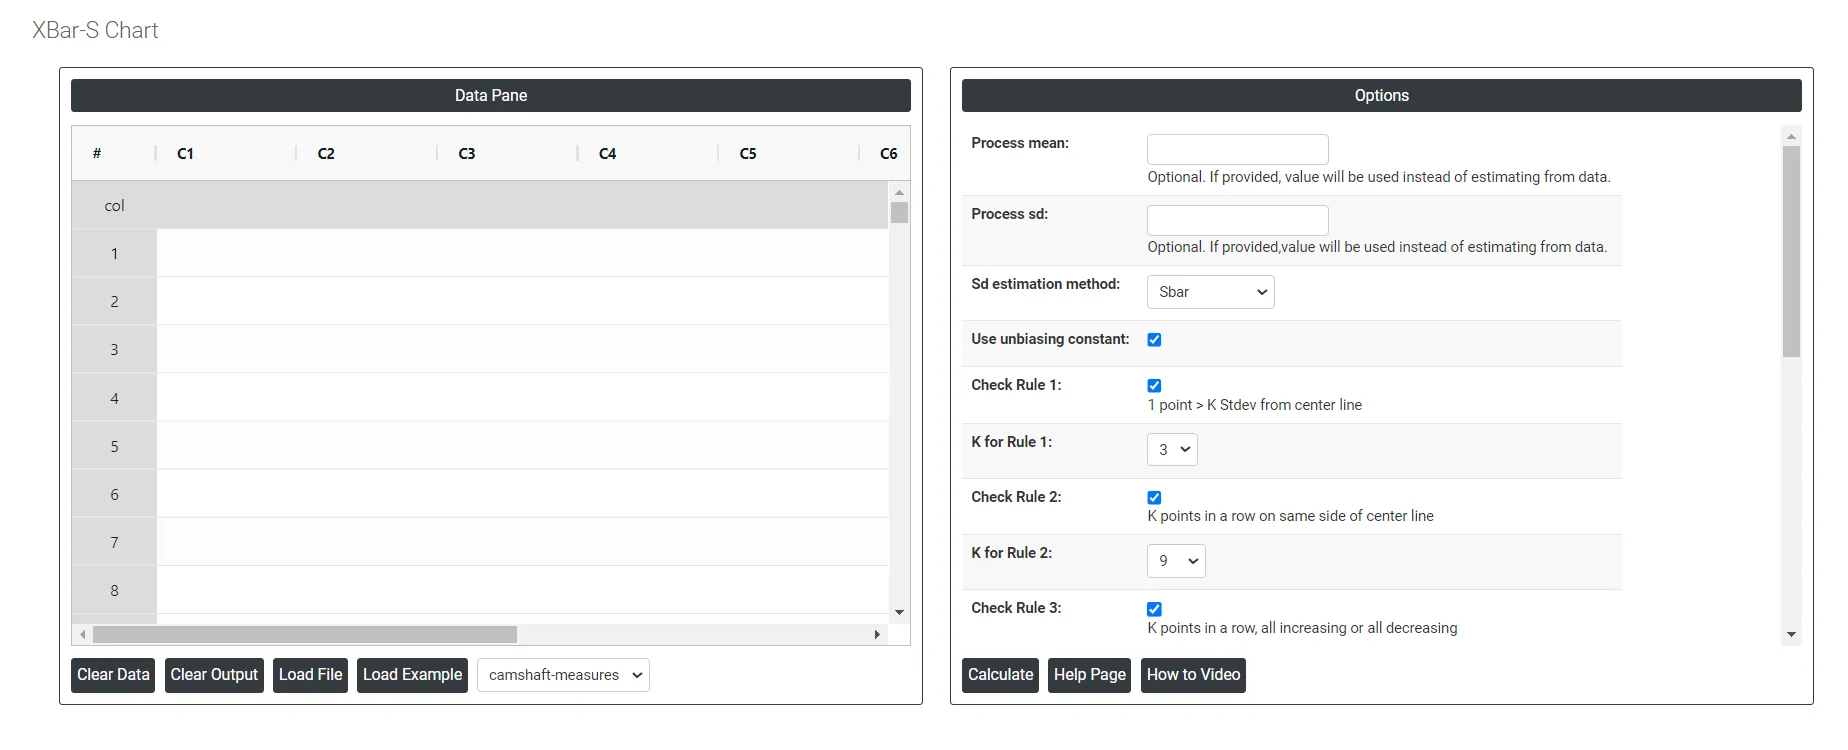
左側にはデータペイン(Data Pane)があります。Data Paneでは、各行が1つのサブグループになります。データは手動で入力するか、Excelシートからデータ全体をコピー(Ctrl+C)してここに貼り付ける(Ctrl+V)ことができます。
Load example: サンプルデータが読み込まれます。
Load File: Excelのデータを直接読み込むために使用します。
右側では、次の項目を指定するだけです。
- Process mean: 工程から得た一連の測定値または観測値の平均値です。時間の経過に伴う工程データの中心傾向を表し、工程性能の重要な指標です。入力しない場合は、Zometric Statistical Softwareが与えられたデータから中心線を計算します。
- Process sd: 平均の周りの工程データのばらつき、つまり散らばりの尺度です。工程内の個々のデータ点が工程平均からどの程度離れているかを示します。空欄のままにすると、Zometric Statistical Softwareが与えられたデータから計算します。
- Sd estimation method: 計算方法として2つの選択肢があります。推定方法としてSbarを選ぶか併合標準偏差法を選ぶかによって、結果が変わります。
- Sbar Sd estimation method: 工程のばらつきを監視するため、サブグループの平均標準偏差(Sbar)を計算します。Sbarは、S管理図の管理限界を設定するうえで極めて重要であり、データの散らばりの時間的な変化を示します。この方法により、品質管理の実務において工程変動を一貫して正確に評価できます。
- Pooled Sd estimation method: 併合標準偏差はサブグループの分散の加重平均であり、大きいサブグループほど全体の推定値に大きく影響します。この方法は、工程が安定している場合に、より正確な標準偏差の推定値を与えます。
- Use unbiasing constants for pooled sd: このオプションは、Pooled Stdev法で標準偏差(Stdev)を推定する場合にのみ適用されます。
- Check Rule 1: 1 point > K Stdev from center line: データ点が中心線からK標準偏差離れているとは、平均から標準偏差のK倍離れていることを意味します。これは統計的工程管理において重要です。データ点が許容範囲内にあるのか、それとも対処が必要な工程の問題があるのかを示すからです。一般に、中心線から3標準偏差を超えて離れたデータ点は外れ値とみなされ、さらなる調査が必要になる場合があります。
- Check Rule 2: K points in a row on same side of center line: データセットで中心線の同じ側にK点が連続する場合、工程平均がシフトした可能性を示唆します。原因としては、測定誤差、サンプリングの偏り、データに内在する真のパターンなど、さまざまな要因が考えられます。
- Check Rule 3: K points in a row, all increasing or all decreasing: この検定は、連続するK点が次のいずれかの条件を満たす場合に、工程の傾向またはドリフトを示します。
- すべての点が増加している(つまり、各点のy座標が直前の点より大きい)
- すべての点が減少している(つまり、各点のy座標が直前の点より小さい)
- Check Rule 4: K points in a row, alternating up and down: 連続するK点がのこぎり歯状に上下を交互に繰り返す場合、その変動はランダムではなく系統的です。工程の過剰調整や、2台の機械、2人の作業者、2つの原材料供給元の交互使用などの要因が原因となることがあります。
- Check Rule 5: K out of K + 1 points > 2 standard deviation from center line (same side): 連続するK+1点のうちK点が中心線の同じ側にあり、中心線から2標準偏差を超えて離れている場合、工程が管理外れになっている可能性を示唆します。問題を特定して修正するため、特殊原因を調査する必要があります。
- Check Rule 6: K out of K + 1 points > 1 standard deviation from center line (same side): 連続するK+1点のうちK点が中心線の同じ側で中心線から1標準偏差を超えて離れている場合、工程平均に小さなシフトが生じている可能性を示します。
- Check Rule 7: K points in a row within 1 standard deviation of center line (either side): 連続するK点が中心線から1標準偏差以内にある場合、変動は管理限界から予測されるより小さくなっています。これは良好な管理の証拠ではありません。多くの場合、層別されたデータや、広すぎる管理限界を示しています。
- Check Rule 8: K points in a row > 1 standard deviation from center line (either side): 連続するK点が中心線から1標準偏差を超えて離れている場合、混合パターンを示します。これは、たとえば2つの異なる工程の流れのデータが混ざっているときに、点が中心線を避けて管理限界の近くに位置するパターンです。
Download as Excel: 結果をExcel形式で出力します。Excel形式は簡単に編集でき、load fileオプションを使って計算用に再読み込みできます。
Xbar-S管理図の計算式
このセクションでは、Xbar管理図とS管理図の管理限界の計算方法を説明します。まず、以下の計算で使用する用語の説明を確認してください。
用語説明
x_{ij}
j番目 の観測値(第 i番目 のサブグループ内)
n_i
観測値の数(サブグループ i)
\sum x
すべての個々の観測値の合計
\sum n
観測値の総数
μ
工程平均
k
Test 1のパラメーター(既定値は3)
σ
工程の標準偏差
S_i
サブグループiの標準偏差
m
サブグループの数
\overline x_i
平均(サブグループ i)
µ_ν
サブグループの分散の平均
c_4 ()
かっこ内に指定した値に対応する不偏化定数c4 の値
c_5 ()
かっこ内に指定した値に対応する不偏化定数c5 の値
Γ()
ガンマ関数
Xbar管理図の計算式
- 打点:各打点 \overline x_i は、サブグループ i の観測値の平均を表します。
\overline x_i = \frac{\sum\limits_{j=1}^{n_i} x_{ij}}{n_i}
- 中心線:中心線は工程平均(µ)を表します。
\overline{\overline{X}} = \frac{∑x}{∑n}
- 管理限界:
- 下方管理限界:各サブグループ i の下方管理限界の値は、次のように計算されます。
LCL_i= µ- \frac{kσ}{√(n_i )}
- 上方管理限界:各サブグループ i の上方管理限界の値は、次のように計算されます。
- 上方管理限界:各サブグループ i の上方管理限界の値は、次のように計算されます。
UCL_i= µ+ \frac{kσ}{√(n_i )}
S管理図の計算式
- 打点:各打点 s_i は、サブグループ i の標準偏差を表します。
- 中心線:中心線はサブグループの平均標準偏差を表します。不偏化定数を使用しない場合、Zometricは工程の標準偏差 σを使用します。
\overline S = σ
...........................不偏化定数を使用する場合(既定)、Zometricは各サブグループ iの中心線の値を次のように計算します。
\overline S_i = c_4 (n_i) σ
- 管理限界:
- 下方管理限界:
不偏化定数を使用する場合:
LCL_i = [c_4 (n_i)×σ]-[kσ× c_5 (n_i)]
不偏化定数を使用しない場合:
LCL_i = σ-k[\frac{c_5 (n_i)}{c_4 (n_i)}]σ
上方管理限界:
不偏化定数を使用する場合
UCL_i = [c_4 (n_i)×σ]+[kσ× c_5 (n_i)]
不偏化定数を使用しない場合:
UCL_i = σ+k[\frac{c_5 (n_i)}{c_4 (n_i)}]σ
シグマ(サブグループ内標準偏差)の推定式
Sbar法を使用する場合:
............................不偏化定数を使用しない場合、\overline S はサブグループの標準偏差の平均です。
\overline S = \frac{\sum S_i}{m}
............................不偏化定数 c4(ni) を使用する場合、\overline S は次のように計算されます。
h_i = \frac {c_4 (n_i)^2}{1-c_4 (n_i)^2}
............................サブグループサイズが一定の場合、\overline S は次のとおりです。
\overline S = \frac {\sum S_i}{m×c_4(n_i)}
併合標準偏差法を使用する場合:
併合標準偏差(Sp)は次の式で与えられます。
S_p = \sqrt\frac{\sum\limits_{i}^{} \sum\limits_{j}^{} (x_{ij}-\overline x_i)^2 }{\sum\limits_{i}^{} (n_{i}-1)}
サブグループサイズが一定の場合、Sp は次のように計算することもできます。
S_p = \sqrt µ_ν
不偏化定数の計算式
- c_4 () と c_5 ():
c_4 (N) = {\sqrt \frac {2}{N-1}}\frac{Γ\frac{N}{2}}{Γ\frac{N-1}{2}}
c_5 (N) = \sqrt {1 - c_4(N)^2}
よくある質問
Xbar-S管理図とは何ですか?
Xbar-S管理図は、サブグループで得られる計量値データ用の一対の管理図です。Xbar管理図はサブグループの平均を時系列で追跡して工程平均のシフトを検出し、S管理図はサブグループの標準偏差をプロットして工程のばらつきの変化を検出します。大きいサブグループに適しており、範囲に基づく管理図よりも広がりを正確に把握できます。
Xbar-R管理図ではなくXbar-S管理図を使用すべきなのはどのような場合ですか?
観測値が9個以上のサブグループにはXbar-S管理図を使用します。サブグループが大きくなると、範囲は工程シグマの推定量として効率が低下し、サブグループの標準偏差の方が優れているためです。サブグループサイズが2〜8の場合はXbar-R管理図を、サブグループがない場合はI-MR管理図を使用します。
Xbar-S管理図にはどのくらいのデータが必要ですか?
信頼できる結果を得るため、観測値は合計で60個以上収集します。管理限界が正確になるよう、データは時間順に入力し、等間隔で収集し、工程の出力を代表する合理的なサブグループを使用し、サブグループ内の観測値に相関がないようにします。
S管理図の管理限界はどのように計算しますか?
不偏化定数を使用する場合(既定)、サブグループiのS管理図の中心線はc4(ni)×シグマであり、管理限界はc4(ni)×シグマ±k×シグマ×c5(ni)です。kの既定値は3です。シグマはSbar法または併合標準偏差で推定できます。